 Repositorio
 Investigación
GreenVLA · greenvla
Green-VLA: modelo de visión, lenguaje y acción por etapas para robots generalistas
Visión-lenguaje-acciónEL DIRECTORIO DE IA INCORPORADO
Explore modelos de visión, lenguaje y acción y modelos básicos de robótica para percepción, manipulación y control.
Repositorio
Investigación
Green-VLA: modelo de visión, lenguaje y acción por etapas para robots generalistas
Visión-lenguaje-acción Repositorio
 Investigación
Código para RISE: Política de robot de mejora automática con modelo composicional del mundo
Modelos mundiales Repositorio
 Investigación
VLA-RFT proporciona recursos de ajuste de refuerzo para modelos de visión-lenguaje-acción.
Visión-lenguaje-acción Repositorio
 Investigación
Un VLA mejorado según el modelo mundial para una manipulación diestra orientable, junto con infraestructura de entrenamiento optimizada.
Modelos mundiales Repositorio
 Investigación
Una implementación básica para la detección de captación a partir de datos de nubes de puntos.
Modelos atrapantes Repositorio
 Código abierto
https://arxiv.org/abs/2312.10807
Políticas de robots Repositorio
 Investigación
Implementación ligera del modelo de mundo robótico (RWM) y del modelo de mundo robótico consciente de la incertidumbre (RWM-U)
Modelos mundiales Repositorio
 Investigación
WholebodyVLA estudia representaciones latentes de VLA para la locomoción y manipulación de todo el cuerpo.
Visión-lenguaje-acción Repositorio
 Investigación
3D-CovDiffusion implementa una política de difusión compatible con 3D para la planificación de rutas de cobertura.
Políticas de robots Repositorio
 Investigación
El repositorio oficial de la primera versión del modelo de fundación ACE-Brain.
Visión-lenguaje-acción Repositorio
 Investigación
ACOT-VLA-WM es un marco robótico avanzado de visión, lenguaje y acción que utiliza un modelo mundial predictivo para generar subobjetivos visuales, mejorando la precisión de la manipulación robótica a largo plazo y...
Modelos mundiales Repositorio
 Investigación
Aether: modelado mundial unificado con conciencia geométrica
Modelos mundiales Repositorio
 Código abierto
El repositorio oficial de artículos: Robot agente: un marco inspirado en el cerebro para modelos de visión, lenguaje y acción en agentes encarnados
Visión-lenguaje-acción Repositorio
 Investigación
Código oficial para "Locomoción adversaria e imitación de movimiento para el aprendizaje de políticas humanoides"
Políticas de robots Repositorio
 Investigación
Anchor-Align estudia el ajuste de VLA con anclaje de representación y alineación de lenguaje-acción.
Visión-lenguaje-acción Repositorio
 Investigación
AnyLoc proporciona un código de investigación de reconocimiento visual de lugares para la localización.
Modelos de percepción Repositorio
 Investigación
Aprendizaje de imitación basado en waypoints para manipulación robótica
Políticas de robots Repositorio
 Investigación
BFM_Zero: un modelo básico de comportamiento rápido para el control humanoide mediante aprendizaje por refuerzo no supervisado
Políticas de robots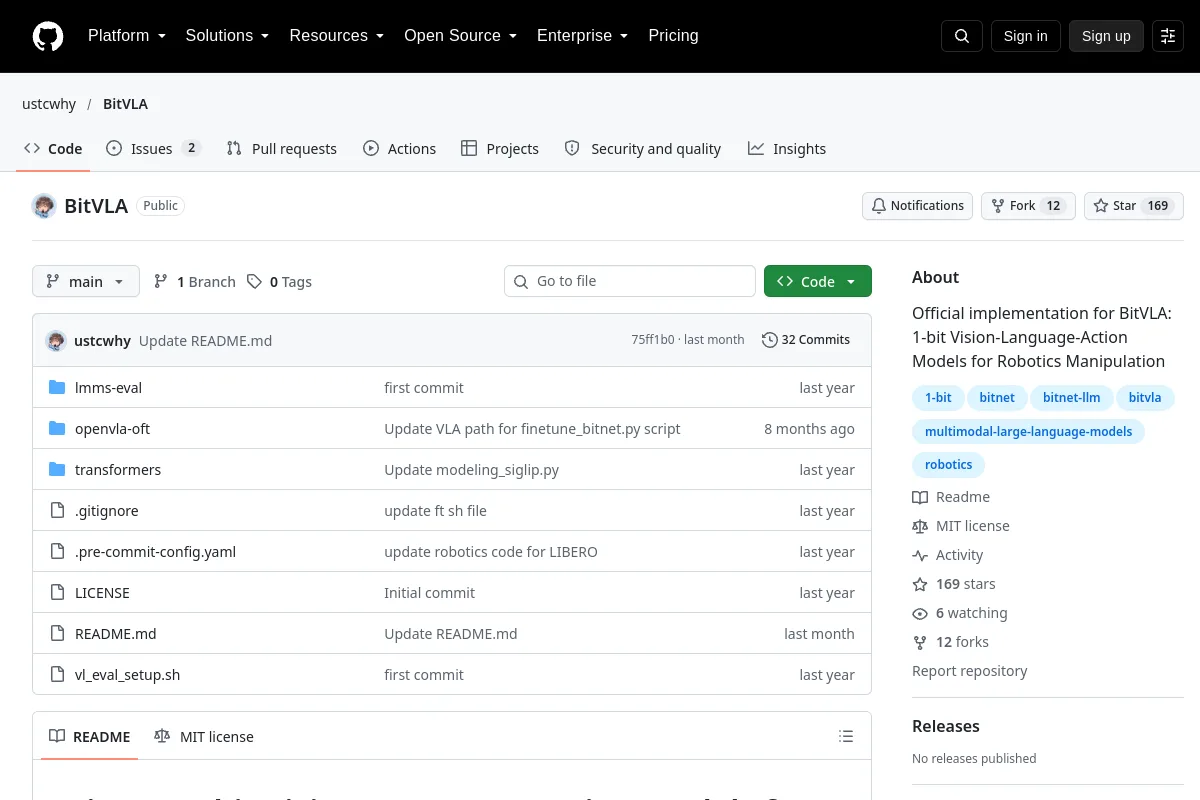 Repositorio
 Investigación
BitVLA implementa modelos de visión, lenguaje y acción de 1 bit para manipulación robótica.
Visión-lenguaje-acción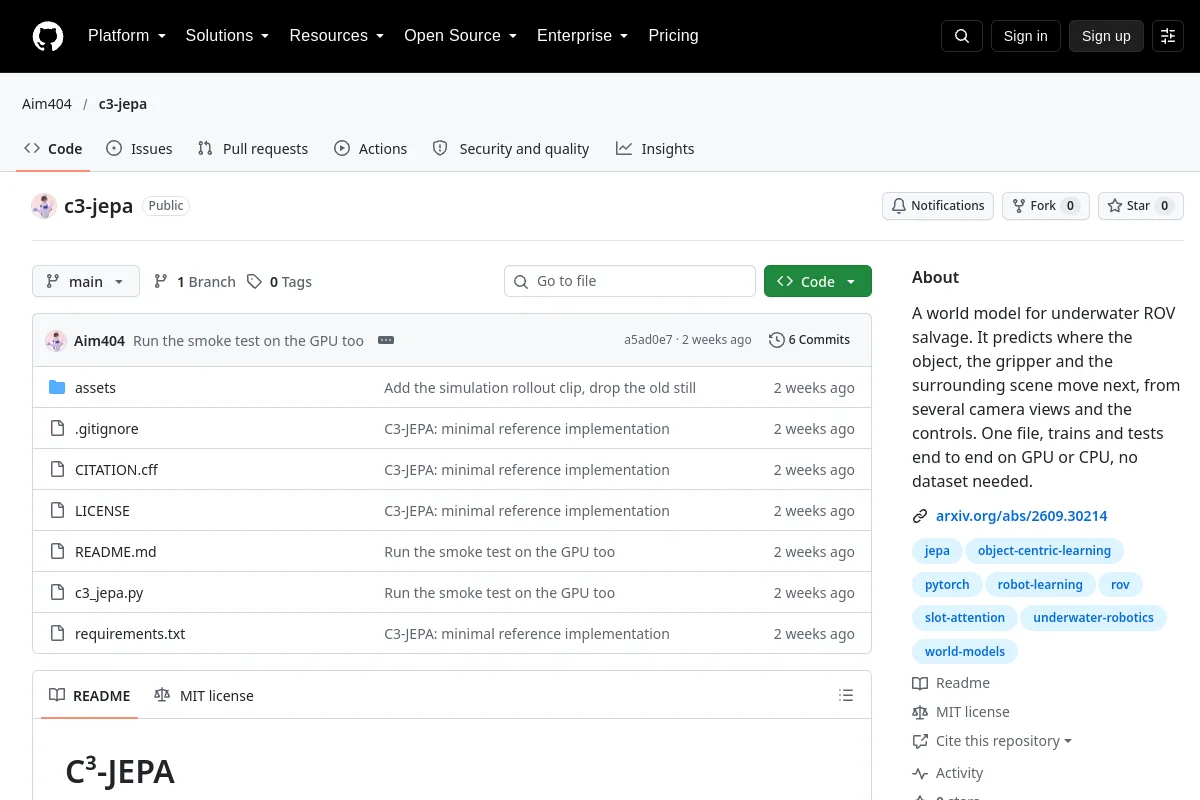 Repositorio
 Investigación
C³-JEPA estudia un modelo mundial de múltiples vistas para el rescate submarino de ROV.
Modelos mundiales Repositorio
 Investigación
CATok estudia la tokenización de acciones causales para políticas de robots con recocido condicional en coincidencia de flujo.
Visión-lenguaje-acción Repositorio
 Investigación
CLP-VLA proporciona código de evaluación y ajuste fino centrado en capas para modelos VLA.
Visión-lenguaje-acción Repositorio
 Investigación
La política de coherencia estudia la destilación de la política visomotora utilizando modelos de coherencia.
Políticas de robots Repositorio
 Investigación
Repositorio oficial de códigos del artículo "CoorDex: coordinación de prioridades de cuerpo y mano para una manipulación locoide humana diestra continua"
Políticas de robots¿Conoce algún recurso que pertenezca aquí?