 Référentiel
 Recherche
GreenVLA · greenvla
Green-VLA : modèle vision-langage-action par étapes pour les robots généralistes
Vision-langage-actionLE RÉPERTOIRE DE L'IA INCORPORÉE
Explorez les modèles vision-langage-action et les modèles de base de la robotique pour la perception, la manipulation et le contrôle.
Référentiel
Recherche
Green-VLA : modèle vision-langage-action par étapes pour les robots généralistes
Vision-langage-action Référentiel
 Recherche
Code pour RISE : politique de robot auto-améliorée avec un modèle mondial compositionnel
Modèles du monde Référentiel
 Recherche
VLA-RFT fournit des ressources de réglage fin du renforcement pour les modèles vision-langage-action.
Vision-langage-action Référentiel
 Recherche
Un VLA amélioré par un modèle mondial pour une manipulation adroite orientable, ainsi qu'une infrastructure d'entraînement optimisée.
Modèles du monde Référentiel
 Recherche
Une implémentation de base pour la détection de saisie à partir de données de nuages de points.
Modèles saisissants Référentiel
 Source ouverte
https://arxiv.org/abs/2312.10807
Politiques relatives aux robots Référentiel
 Recherche
Implémentation légère du modèle mondial robotique (RWM) et du modèle mondial robotique prenant en compte l'incertitude (RWM-U)
Modèles du monde Référentiel
 Recherche
WholebodyVLA étudie les représentations latentes de VLA pour la locomotion et la manipulation du corps entier.
Vision-langage-action Référentiel
 Recherche
3D-CovDiffusion met en œuvre une politique de diffusion prenant en compte la 3D pour la planification du chemin de couverture.
Politiques relatives aux robots Référentiel
 Recherche
Le référentiel officiel de la première version du modèle de fondation ACE-Brain.
Vision-langage-action Référentiel
 Recherche
ACOT-VLA-WM est un cadre robotique Vision-Langage-Action avancé qui utilise un modèle mondial prédictif pour générer des sous-objectifs visuels, améliorant ainsi la précision de la manipulation robotique à long horizon et…
Modèles du monde Référentiel
 Recherche
Aether : modélisation du monde unifiée basée sur la géométrie
Modèles du monde Référentiel
 Source ouverte
Le dépôt officiel de l'article : Agentic Robot : A Brain-Inspired Framework for Vision-Language-Action Models in Embodied Agents
Vision-langage-action Référentiel
 Recherche
Code officiel de « Locomotion contradictoire et imitation de mouvement pour l'apprentissage des politiques humanoïdes »
Politiques relatives aux robots Référentiel
 Recherche
Anchor-Align étudie le réglage fin du VLA avec l'ancrage de la représentation et l'alignement langage-action.
Vision-langage-action Référentiel
 Recherche
AnyLoc fournit un code de recherche de reconnaissance visuelle de lieu pour la localisation.
Modèles de perception Référentiel
 Recherche
Apprentissage par imitation basé sur des points de cheminement pour la manipulation robotique
Politiques relatives aux robots Référentiel
 Recherche
BFM_Zero : un modèle de base comportemental incitatif pour le contrôle humanoïde utilisant l'apprentissage par renforcement non supervisé
Politiques relatives aux robots Référentiel
 Recherche
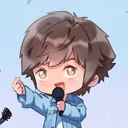
BitVLA implémente des modèles vision-langage-action 1 bit pour la manipulation robotique.
Vision-langage-action Référentiel
 Recherche
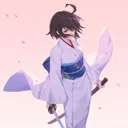
C³-JEPA étudie un modèle mondial multi-vues pour la récupération sous-marine des ROV.
Modèles du monde Référentiel
 Recherche
CATok étudie la tokenisation des actions causales pour les politiques de robots avec recuit conditionnel dans la correspondance de flux.
Vision-langage-action Référentiel
 Recherche
CLP-VLA fournit un code de réglage fin et d'évaluation axé sur les couches pour les modèles VLA.
Vision-langage-action Référentiel
 Recherche
La politique de cohérence étudie la distillation des politiques visuomotrices à l’aide de modèles de cohérence.
Politiques relatives aux robots Référentiel
 Recherche
Référentiel de codes officiel de l'article « CoorDex : Coordinating Body and Hand Priors for Continuous Dexterous Humanoid Loco-Manipulation »
Politiques relatives aux robotsConnaissez-vous une ressource qui a sa place ici ?