 Repozytorium
 Badania
GreenVLA · greenvla
Green-VLA: etapowy model widzenia, języka i działania dla robotów ogólnych
Wizja-język-działanieKATALOG WCIELONEJ AI
Poznaj modele wizji, języka i działania oraz podstawowe modele robotyki w zakresie percepcji, manipulacji i kontroli.
Repozytorium
Badania
Green-VLA: etapowy model widzenia, języka i działania dla robotów ogólnych
Wizja-język-działanie Repozytorium
 Badania
Kod dla RISE: Polityka samodoskonalenia się dotycząca robotów z kompozycyjnym modelem świata
Modele świata Repozytorium
 Badania
VLA-RFT zapewnia zasoby dostrajające wzmocnienie dla modeli wizja-język-działanie.
Wizja-język-działanie Repozytorium
 Badania
Ulepszony na skalę światową model VLA do sterowalnej zręcznej manipulacji, wraz ze zoptymalizowaną infrastrukturą szkoleniową.
Modele świata Repozytorium
 Badania
Podstawowa implementacja wykrywania uchwycenia na podstawie danych chmury punktów.
Chwytanie modeli Repozytorium
 Otwarte źródło
https://arxiv.org/abs/2312.10807
Zasady robotów Repozytorium
 Badania
Lekka implementacja Robotic World Model (RWM) i Robotic World Model (RWM-U)
Modele świata Repozytorium
 Badania
WholebodyVLA bada ukryte reprezentacje VLA dotyczące lokomocji i manipulacji całym ciałem.
Wizja-język-działanie Repozytorium
 Badania
3D-CovDiffusion wdraża politykę rozpowszechniania uwzględniającą 3D do planowania ścieżki pokrycia.
Zasady robotów Repozytorium
 Badania
Oficjalne repozytorium pierwszej wersji modelu podstawowego ACE-Brain.
Wizja-język-działanie Repozytorium
 Badania
ACOT-VLA-WM to zaawansowana platforma robotyki Vision-Language-Action, która wykorzystuje predykcyjny model świata do generowania wizualnych celów cząstkowych, poprawiając dokładność manipulacji robotami w długim horyzoncie i…
Modele świata Repozytorium
 Badania
Eter: ujednolicone modelowanie świata uwzględniające geometrię
Modele świata Repozytorium
 Otwarte źródło
Oficjalne repozytorium artykułu: Agentic Robot: Inspired Brain Framework for Vision-Language-Action Models in Embodied Agents
Wizja-język-działanie Repozytorium
 Badania
Oficjalny kod „Kontradyktoryjnej lokomocji i imitacji ruchu na rzecz uczenia się polityki humanoidalnej”
Zasady robotów Repozytorium
 Badania
Anchor-Align bada dostrajanie VLA z zakotwiczeniem reprezentacji i dopasowaniem języka do działania.
Wizja-język-działanie Repozytorium
 Badania
AnyLoc zapewnia wizualny kod badawczy umożliwiający rozpoznawanie miejsc na potrzeby lokalizacji.
Modele percepcji Repozytorium
 Badania
Nauka imitacji oparta na punktach orientacyjnych w manipulacji robotami
Zasady robotów Repozytorium
 Badania
BFM_Zero: Podstawowy model behawioralny umożliwiający szybką kontrolę humanoidalną przy użyciu uczenia się ze wzmocnieniem bez nadzoru
Zasady robotów Repozytorium
 Badania
BitVLA implementuje 1-bitowe modele wizja-język-działanie do manipulacji robotycznej.
Wizja-język-działanie Repozytorium
 Badania
C³-JEPA bada wielopunktowy model świata w zakresie ratownictwa podwodnego ROV.
Modele świata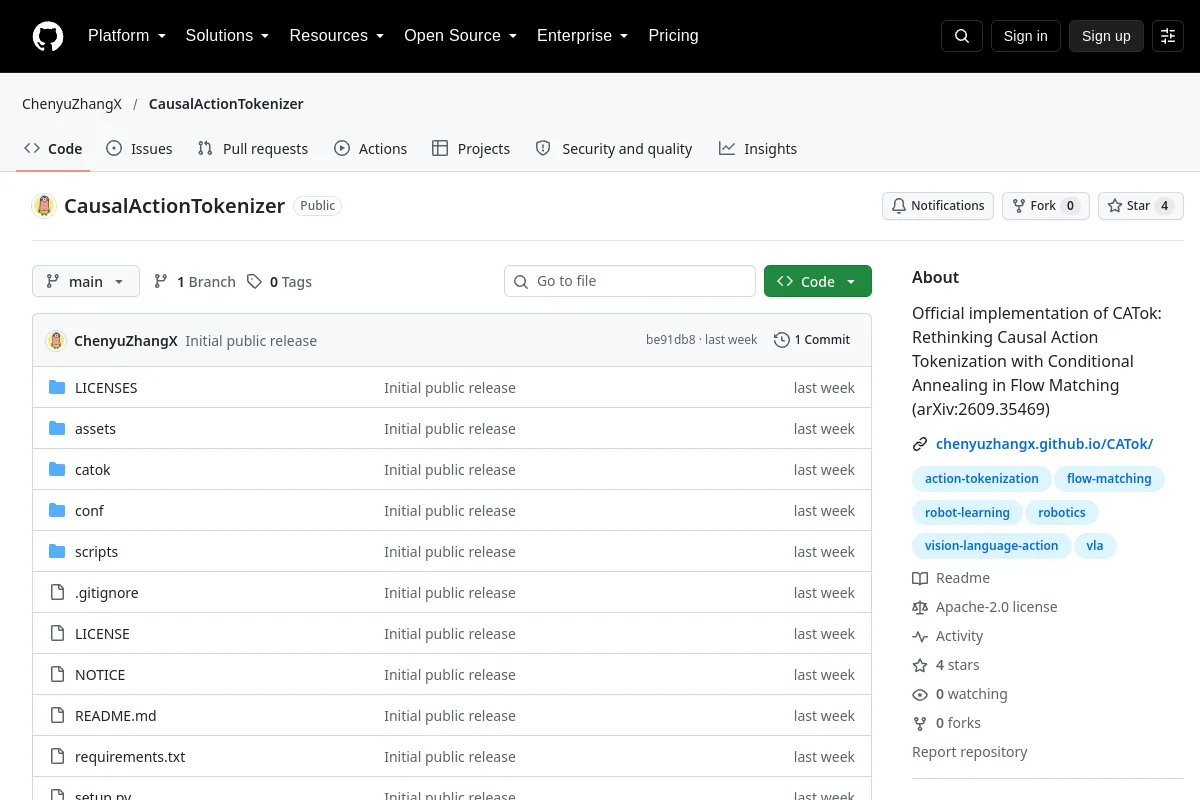 Repozytorium
 Badania
CATok bada tokenizację działań przyczynowych dla polityk robotów z warunkowym wyżarzaniem w dopasowywaniu przepływu.
Wizja-język-działanie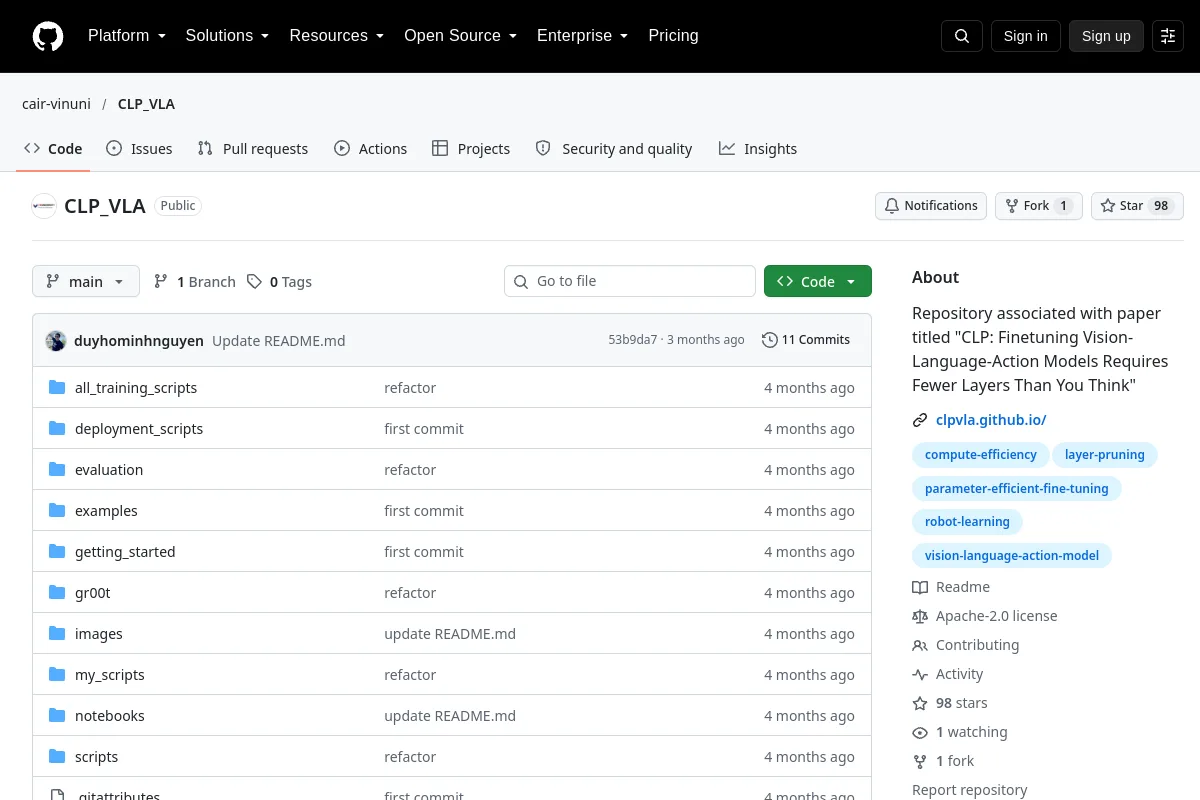 Repozytorium
 Badania
CLP-VLA zapewnia ukierunkowany na warstwy kod dostrajający i ewaluacyjny dla modeli VLA.
Wizja-język-działanie Repozytorium
 Badania
Polityka spójności bada destylację polityki wizuomotorycznej przy użyciu modeli spójności.
Zasady robotów Repozytorium
 Badania
Oficjalne repozytorium kodów artykułu „CoorDex: Koordynacja priorytetów ciała i dłoni w celu ciągłej zręcznej humanoidalnej manipulacji lokomotywą”
Zasady robotówZnasz zasób, który tu pasuje?