 Förvar
 Forskning
GreenVLA · greenvla
Green-VLA: iscensatt vision-språk-handlingsmodell för generalistrobotar
Vision-språk-handlingTHE EMBODIED AI DIRECTORY
Utforska vision-språk-action-modeller och robotmodeller för perception, manipulation och kontroll.
Förvar
Forskning
Green-VLA: iscensatt vision-språk-handlingsmodell för generalistrobotar
Vision-språk-handling Förvar
 Forskning
Kod för RISE: Self-Improving Robot Policy with Compositional World Model
Världens modeller Förvar
 Forskning
VLA-RFT tillhandahåller förstärkande finjusteringsresurser för vision-språk-action-modeller.
Vision-språk-handling Förvar
 Forskning
En världsmodellförbättrad VLA för styrbar skicklig manipulation, tillsammans med optimerad träningsinfra.
Världens modeller Förvar
 Forskning
En baslinjeimplementering för greppdetektering från punktmolndata.
Gripande modeller Förvar
 Öppen källkod
https://arxiv.org/abs/2312.10807
Robotpolitik Förvar
 Forskning
Lättviktsimplementering av Robotic World Model (RWM) och Uncertainty-Aware Robotic World Model (RWM-U)
Världens modeller Förvar
 Forskning
WholebodyVLA studerar latenta VLA-representationer för rörelse och manipulation av hela kroppen.
Vision-språk-handling Förvar
 Forskning
3D-CovDiffusion implementerar en 3D-medveten spridningspolicy för planering av täckningsvägar.
Robotpolitik Förvar
 Forskning
Det officiella arkivet för den första versionen av ACE-Brain-grundmodellen.
Vision-språk-handling Förvar
 Forskning
ACOT-VLA-WM är ett avancerat Vision-Language-Action-robotramverk som använder en prediktiv världsmodell för att generera visuella delmål, förbättra robotmanipulationsnoggrannheten på lång horisont och...
Världens modeller Förvar
 Förvar
 Öppen källkod
Det officiella förrådet för papper: Agentic Robot: A Brain-Inspired Framework for Vision-Language-Action Models in Embodied Agents
Vision-språk-handling Förvar
 Forskning
Officiell kod för "motståndsrörelse och rörelseimitation för humanoid policyinlärning"
Robotpolitik Förvar
 Forskning
Anchor-Align studerar VLA-finjustering med representationsförankring och språkhandlingsanpassning.
Vision-språk-handling Förvar
 Forskning
AnyLoc tillhandahåller forskningskod för visuell platsigenkänning för lokalisering.
Perceptionsmodeller Förvar
 Förvar
 Forskning
BFM_Zero: En styrbar beteendegrundmodell för humanoidstyrning med oövervakad förstärkningsinlärning
Robotpolitik Förvar
 Forskning
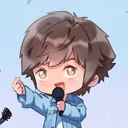
BitVLA implementerar 1-bitars vision-språk-action-modeller för robotmanipulation.
Vision-språk-handling Förvar
 Forskning
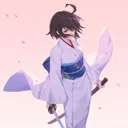
C³-JEPA studerar en multi-view världsmodell för ROV-räddning under vatten.
Världens modeller Förvar
 Forskning
CATok studerar kausal handlingstokenisering för robotpolicyer med villkorad glödgning i flödesmatchning.
Vision-språk-handling Förvar
 Forskning
CLP-VLA tillhandahåller lagerfokuserad finjustering och utvärderingskod för VLA-modeller.
Vision-språk-handling Förvar
 Forskning
Konsistenspolicy studerar visuomotorisk destillation med hjälp av konsistensmodeller.
Robotpolitik Förvar
 Forskning
Officiellt kodarkiv för papper "CoorDex: Coordinating Body and Hand Priors for Continuous Dexterous Humanoid Loco-Manipulation"
RobotpolitikVet du en resurs som hör hemma här?

