 Repository
 Research
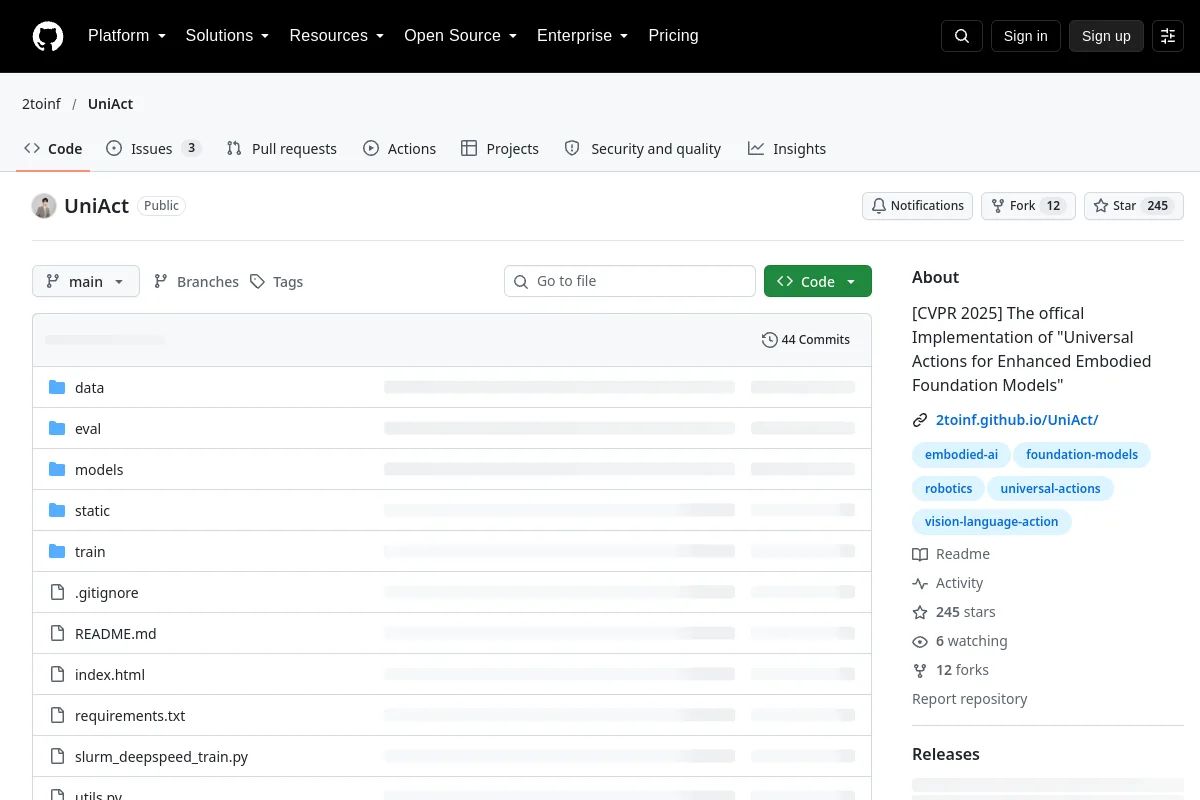
UniAct · 2toinf
UniAct studies universal action representations for embodied foundation models.
Vision-language-actionTHE EMBODIED AI DIRECTORY
Explore vision-language-action models and robotics foundation models for perception, manipulation and control.
Repository
Research
UniAct studies universal action representations for embodied foundation models.
Vision-language-action Repository
 Research
Natural Locomotion, Jumping and Recovery of Quadruped Robot A1 with AMP
Robot policies Repository
 Research
X-VLA studies soft-prompted transformers for cross-embodiment vision-language-action learning.
Vision-language-action Repository
 Research
HiMoE-VLA studies hierarchical mixture-of-experts policies for vision-language-action learning.
Vision-language-action Repository
 Research
DreamDojo studies robot world models learned from human video data.
World models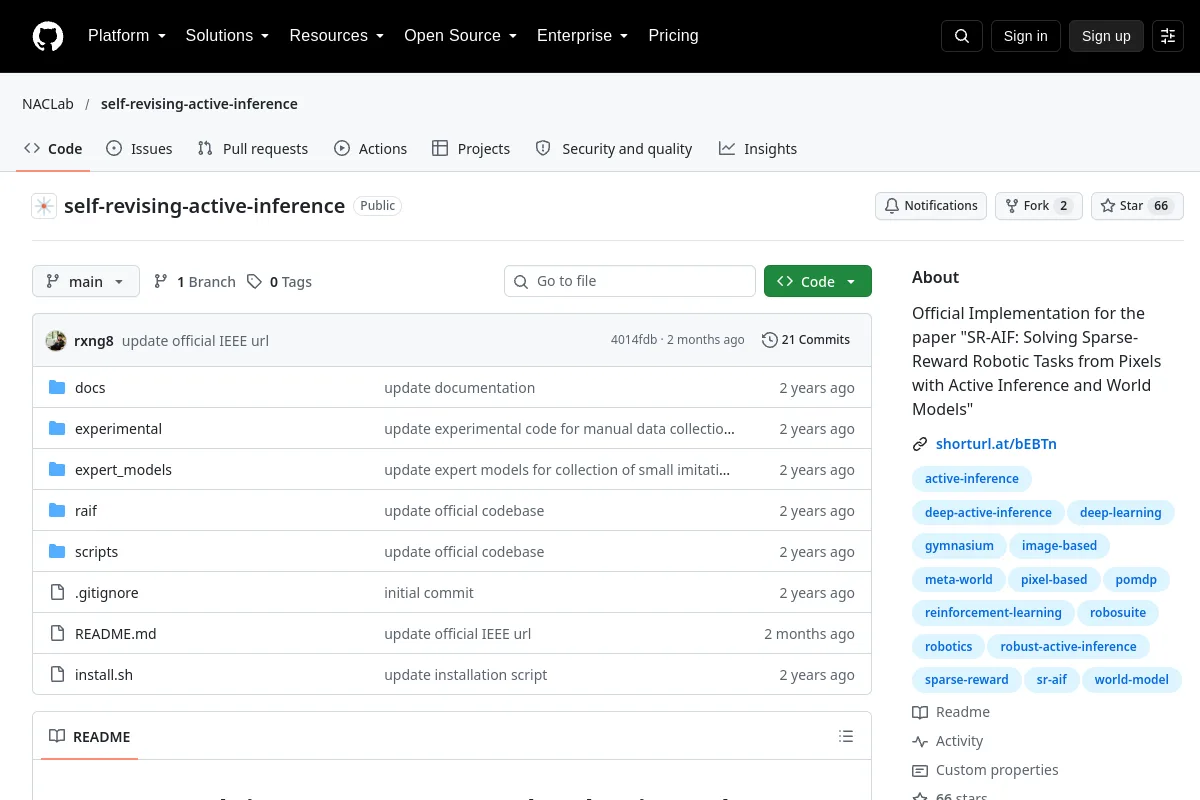 Repository
 Research
Official Implementation for the paper "SR-AIF: Solving Sparse-Reward Robotic Tasks from Pixels with Active Inference and World Models"
World models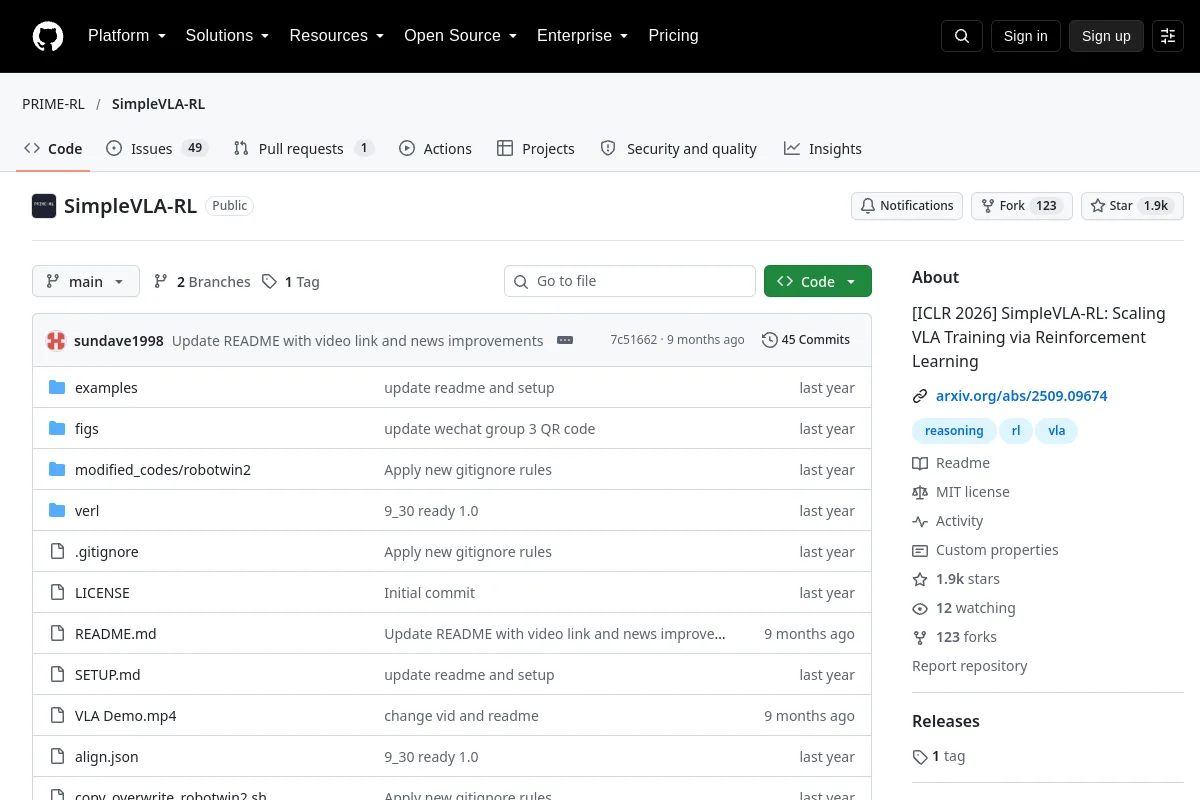 Repository
 Research
SimpleVLA-RL provides reinforcement-learning training resources for VLA policies.
Vision-language-action Repository
 Research
VLAC: A Vision-Language-Action-Critic Model for Robotic Real-World Reinforcement Learning
Vision-language-action Repository
 Research
VLA-RL provides reinforcement-learning code for adapting VLA models to robotic manipulation.
Vision-language-action Repository
 Open source
Building General-Purpose Robots Based on Embodied Foundation Model
Vision-language-action Repository
 Research
LingBot-VLA provides a vision-language-action foundation-model project.
Vision-language-action Repository
 Open source
Codebase for DexMachina: Functional Retargeting for Bimanual Dexterous Manipulation
Robot policies Repository
 Research
FOCA studies future-oriented conditioning for data-efficient VLA adaptation.
Vision-language-action Repository
 Open source
A Minimalist Retargeting-Guided Reinforcement Learning Recipe for Dexterous Manipulation
Robot policies Repository
 Open source
Visual Imitation Enables Contextual Humanoid Control. CoRL 2025, Best Student Paper Award.
Robot policies Website
 Repository
 Research
Uni-NaVid: A Video-based Vision-Language-Action Model for Unifying Embodied Navigation Tasks.
Vision-language-action Repository
 Repository
 Research
Language-guided 3D value-map planning for robot manipulation.
Language-guided planning Repository
 Research
Being-H is BeingBeyond's family of human-centric embodied foundation models.
Robot policies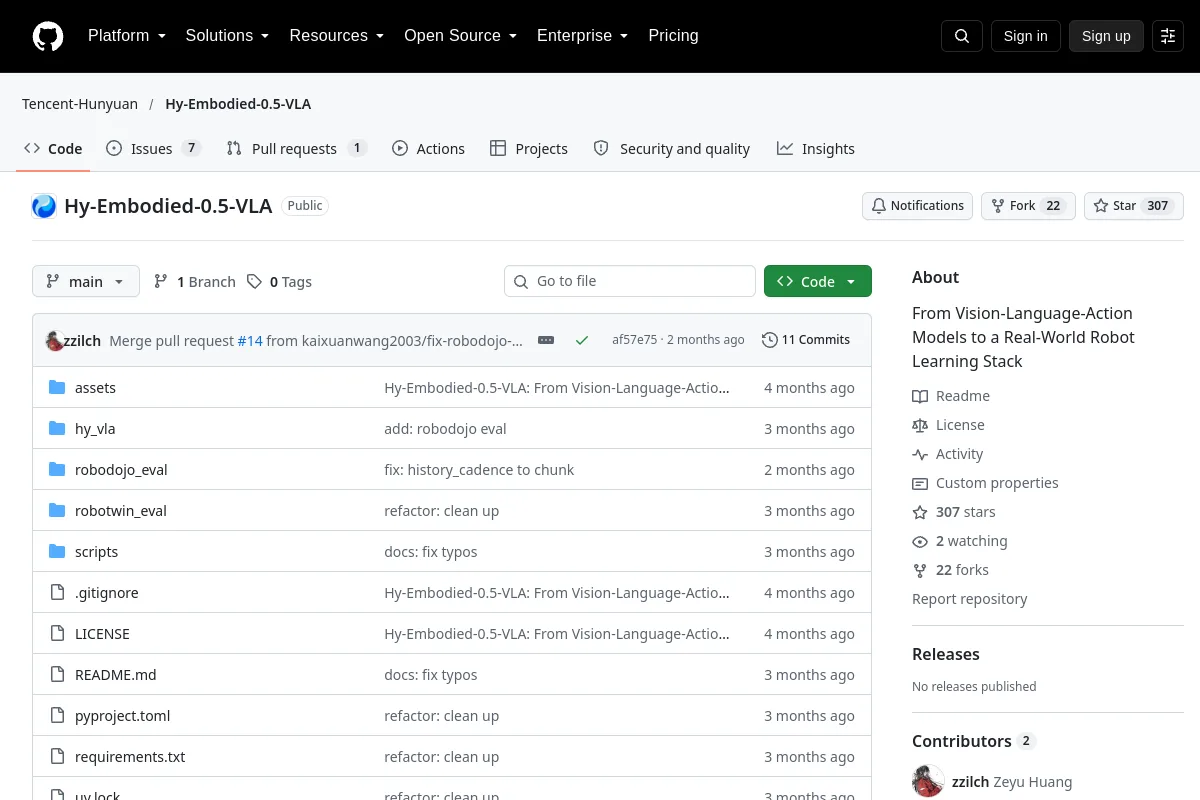 Repository
 Research
From Vision-Language-Action Models to a Real-World Robot Learning Stack
Vision-language-action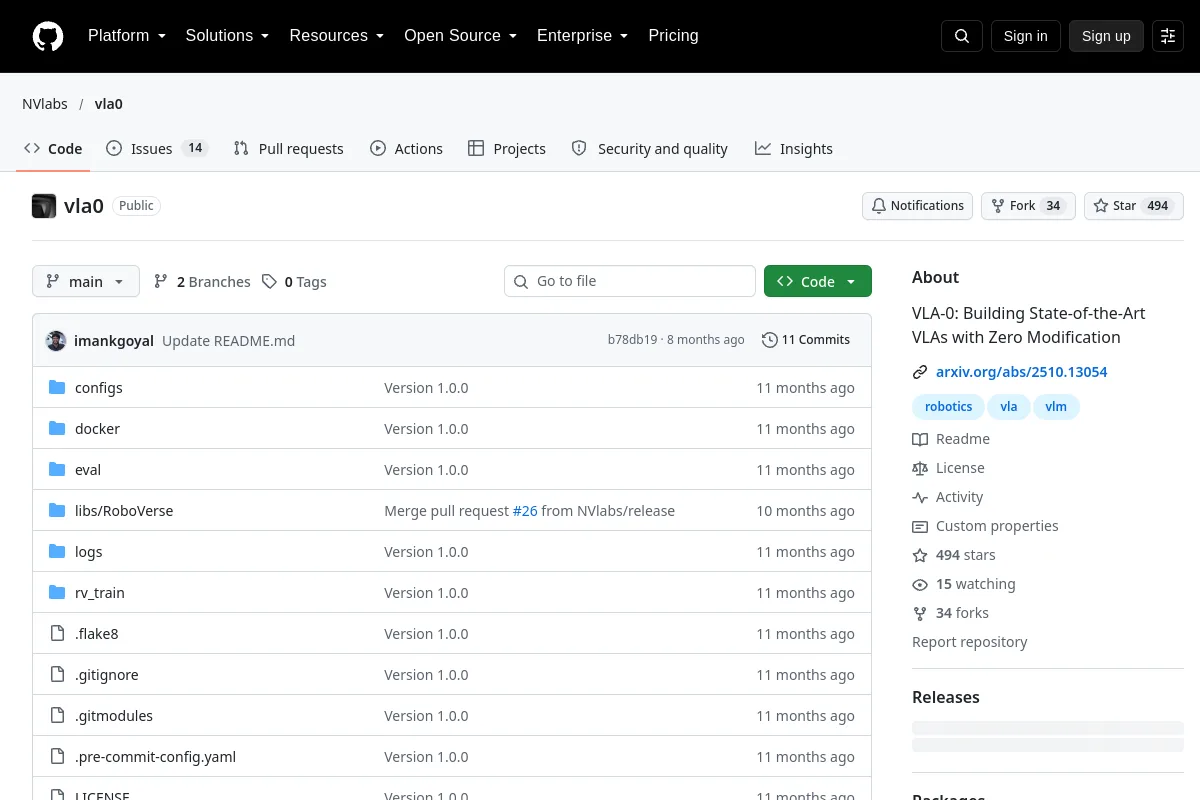 Repository
 Research
VLA-0 provides research code for building vision-language-action models from vision-language models.
Vision-language-action Repository
 Research
A unified framework for training, fine-tuning, and evaluating World Action Models
World models Repository
 Research
ICCV 2025 | TesserAct: Learning 4D Embodied World Models
World modelsKnow a resource that belongs here?