 Repository
 Forschung
UniAct · 2toinf
UniAct untersucht universelle Aktionsdarstellungen für verkörperte Fundamentmodelle.
Vision-Sprache-AktionDAS VERKÖRPERTE KI-VERZEICHNIS
Entdecken Sie Vision-Sprach-Aktionsmodelle und Robotik-Grundlagenmodelle für Wahrnehmung, Manipulation und Kontrolle.
Repository
Forschung
UniAct untersucht universelle Aktionsdarstellungen für verkörperte Fundamentmodelle.
Vision-Sprache-Aktion Repository
 Forschung
Natürliche Fortbewegung, Springen und Erholung des vierbeinigen Roboters A1 mit AMP
Roboterrichtlinien Repository
 Forschung
X-VLA untersucht Soft-Prompted-Transformatoren für das verkörperungsübergreifende Lernen von Vision, Sprache und Aktion.
Vision-Sprache-Aktion Repository
 Forschung
HiMoE-VLA untersucht hierarchische Expertenmischungsrichtlinien für Vision-Sprache-Aktion-Lernen.
Vision-Sprache-Aktion Repository
 Forschung
DreamDojo untersucht Roboterweltmodelle, die aus menschlichen Videodaten gelernt wurden.
Weltmodelle Repository
 Forschung
Offizielle Implementierung für den Artikel „SR-AIF: Solving Sparse-Reward Robotic Tasks from Pixels with Active Inference and World Models“
Weltmodelle Repository
 Forschung
SimpleVLA-RL bietet Schulungsressourcen zur Verstärkung des Lernens für VLA-Richtlinien.
Vision-Sprache-Aktion Repository
 Forschung
VLAC: Ein visionäres, handlungskritisches Modell für robotergestütztes Verstärkungslernen in der realen Welt
Vision-Sprache-Aktion Repository
 Forschung
VLA-RL bietet Reinforcement-Learning-Code zur Anpassung von VLA-Modellen an die Robotermanipulation.
Vision-Sprache-Aktion Repository
 Open Source
Bau von Allzweckrobotern basierend auf dem verkörperten Fundamentmodell
Vision-Sprache-Aktion Repository
 Forschung
LingBot-VLA bietet ein Vision-Sprache-Aktion-Grundmodellprojekt.
Vision-Sprache-Aktion Repository
 Open Source
Codebasis für DexMachina: Funktionales Retargeting für bimanuelle geschickte Manipulation
Roboterrichtlinien Repository
 Forschung
Das BAZL untersucht zukunftsorientierte Konditionierung zur dateneffizienten VLA-Anpassung.
Vision-Sprache-Aktion Repository
 Open Source
Ein minimalistisches Retargeting-gesteuertes Reinforcement-Lernrezept für geschickte Manipulation
Roboterrichtlinien Repository
 Open Source
Visuelle Nachahmung ermöglicht kontextuelle humanoide Kontrolle. CoRL 2025, Preis für die beste studentische Arbeit.
Roboterrichtlinien Website
 Forschung
Ein roboterpolitisches Projekt, das Weltmodelldarstellungen verwendet.
Weltmodelle Repository
 Forschung
Uni-NaVid: Ein videobasiertes Vision-Sprach-Aktionsmodell zur Vereinheitlichung verkörperter Navigationsaufgaben.
Vision-Sprache-Aktion Repository
 Forschung
Weltmodellierungsherausforderung für humanoide Roboter
Weltmodelle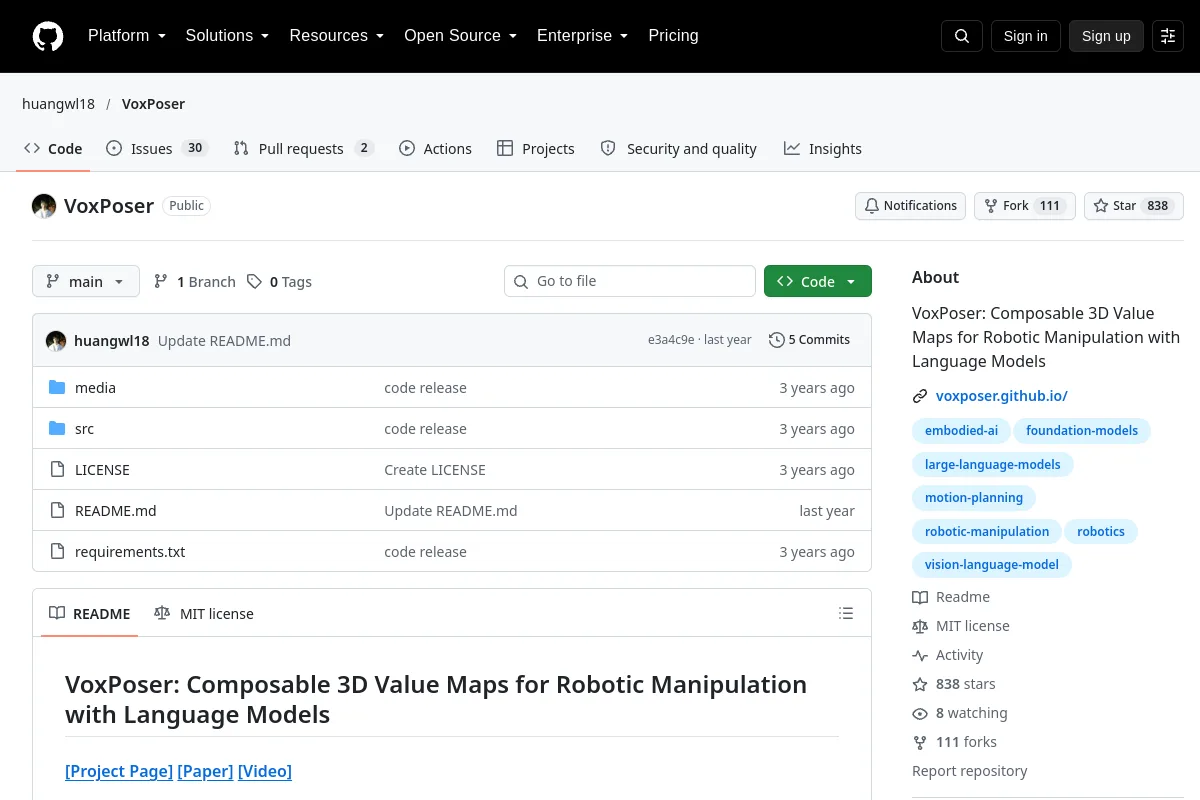 Repository
 Forschung
Sprachgesteuerte 3D-Wertekartenplanung für die Robotermanipulation.
Sprachgeführte Planung Repository
 Forschung
Being-H ist BeingBeyonds Familie menschenzentrierter verkörperter Grundmodelle.
Roboterrichtlinien Repository
 Forschung
Von Vision-Language-Action-Modellen zu einem realen Roboter-Lernstapel
Vision-Sprache-Aktion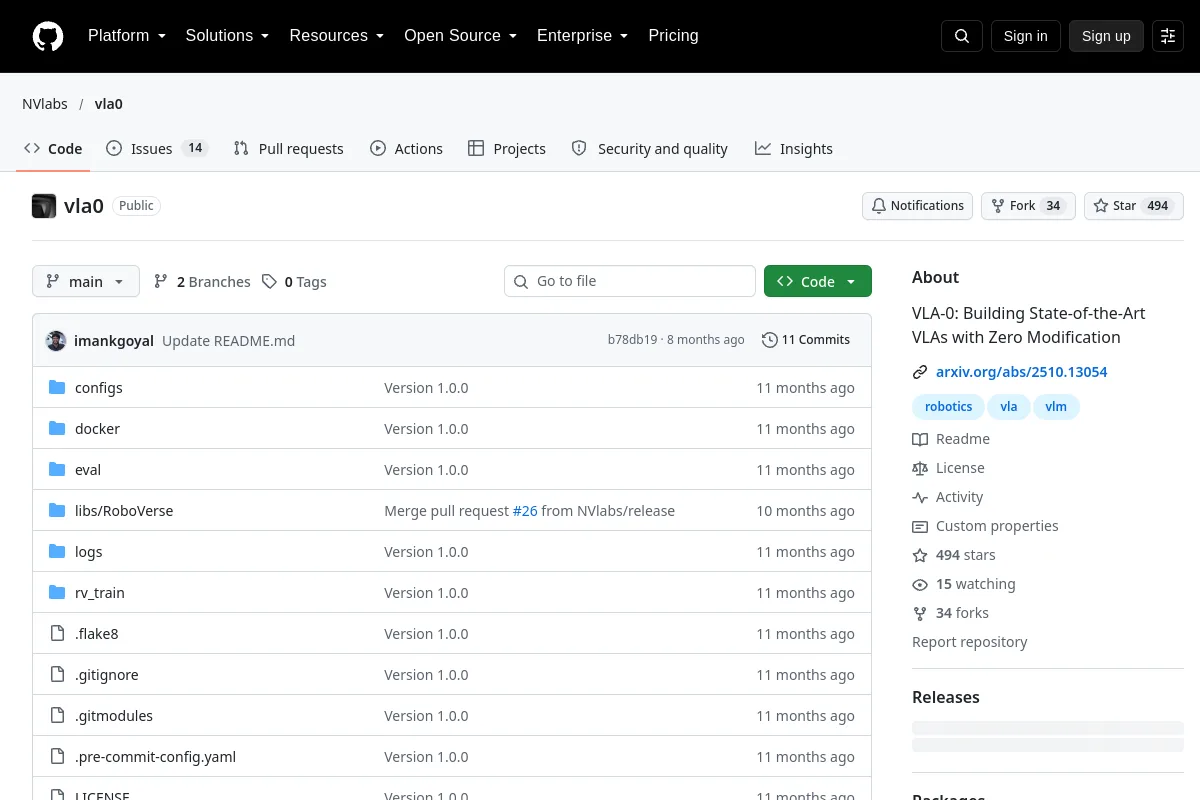 Repository
 Forschung
VLA-0 stellt Forschungscode zum Erstellen von Vision-Sprach-Aktionsmodellen aus Vision-Sprachmodellen bereit.
Vision-Sprache-Aktion Repository
 Forschung
Ein einheitlicher Rahmen für das Training, die Feinabstimmung und die Bewertung von Weltaktionsmodellen
Weltmodelle Repository
 Forschung
ICCV 2025 | TesserAct: Lernen von 4D-verkörperten Weltmodellen
WeltmodelleKennen Sie eine Ressource, die hierher gehört?