 Deposito
 Fonte aperta
wall-x · X-Square-Robot
Costruzione di robot per uso generale basati sul modello di fondazione incarnata
Visione-linguaggio-azioneLA DIRECTORY DELL'AI INCORPORATA
Esplora VLA e le risorse del modello di base robotico che collegano percezione, istruzioni e azioni.
Deposito
Fonte aperta
Costruzione di robot per uso generale basati sul modello di fondazione incarnata
Visione-linguaggio-azione Deposito
 Ricerca
LingBot-VLA fornisce un progetto modello di base visione-linguaggio-azione.
Visione-linguaggio-azione Deposito
 Ricerca
L'UFAC studia il condizionamento orientato al futuro per un adattamento VLA efficiente in termini di dati.
Visione-linguaggio-azione Deposito
 Ricerca
Uni-NaVid: un modello di visione-linguaggio-azione basato su video per unificare le attività di navigazione incarnate.
Visione-linguaggio-azione Deposito
 Ricerca
Dai modelli di visione-linguaggio-azione a uno stack di apprendimento per robot del mondo reale
Visione-linguaggio-azione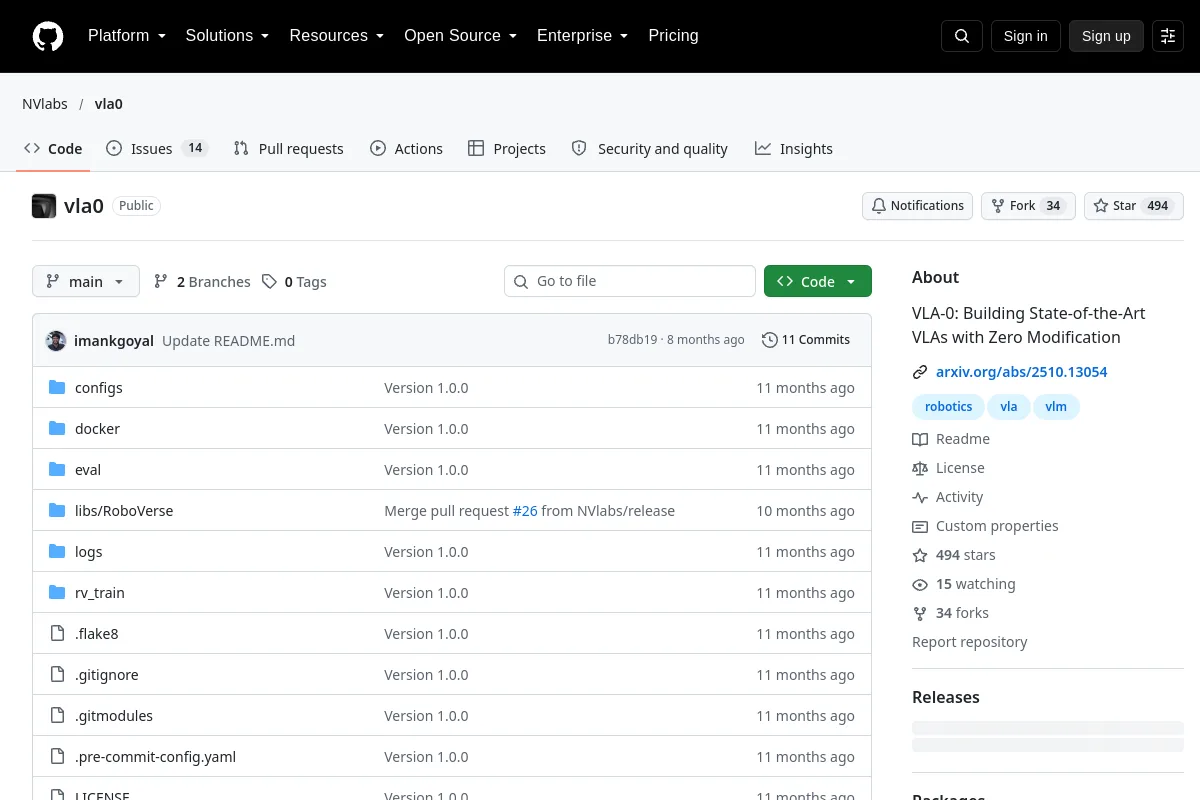 Deposito
 Ricerca
VLA-0 fornisce codice di ricerca per costruire modelli visione-linguaggio-azione da modelli visione-linguaggio.
Visione-linguaggio-azione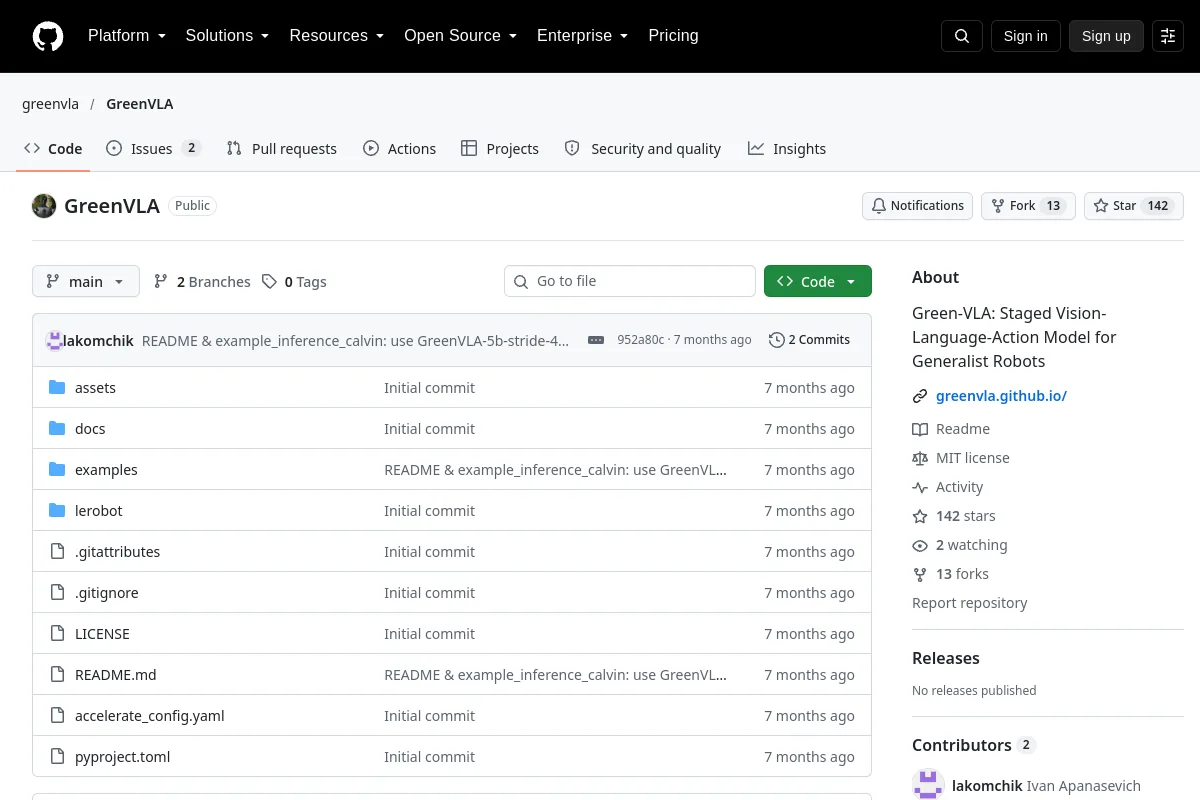 Deposito
 Ricerca
Green-VLA: modello di visione-linguaggio-azione a fasi per robot generalisti
Visione-linguaggio-azione Deposito
 Ricerca
VLA-RFT fornisce risorse di rinforzo per la messa a punto dei modelli visione-linguaggio-azione.
Visione-linguaggio-azione Deposito
 Ricerca
WholebodyVLA studia le rappresentazioni latenti di VLA per la locomozione e la manipolazione di tutto il corpo.
Visione-linguaggio-azione Deposito
 Ricerca
Il repository ufficiale della prima versione del modello di fondazione ACE-Brain.
Visione-linguaggio-azione Deposito
 Fonte aperta
Il repository ufficiale dell'articolo: Agentic Robot: A Brain-Inspired Framework for Vision-Language-Action Models in Emfilled Agents
Visione-linguaggio-azione Deposito
 Ricerca
Anchor-Align studia la messa a punto del VLA con l'ancoraggio della rappresentazione e l'allineamento linguaggio-azione.
Visione-linguaggio-azione Deposito
 Ricerca
BitVLA implementa modelli di visione-linguaggio-azione a 1 bit per la manipolazione robotica.
Visione-linguaggio-azione Deposito
 Ricerca
CATok studia la tokenizzazione delle azioni causali per le policy dei robot con ricottura condizionale nella corrispondenza del flusso.
Visione-linguaggio-azione Deposito
 Ricerca
CLP-VLA fornisce codice di valutazione e regolazione fine focalizzato sui livelli per i modelli VLA.
Visione-linguaggio-azione Deposito
 Ricerca
DEAS Isaac GR00T fornisce risorse di configurazione che combinano DEAS, Isaac GR00T e RoboCasa.
Visione-linguaggio-azione Deposito
 Ricerca
Dexora fornisce risorse politiche VLA per la destrezza bimanuale ad alto grado di libertà.
Visione-linguaggio-azione Deposito
 Ricerca
DynamicVLA fornisce risorse di ricerca per la manipolazione robotica di oggetti dinamici.
Visione-linguaggio-azione Deposito
 Ricerca
Il progetto EAI2025 combina la mappatura semantica 3D e l'implementazione VLA per la manipolazione.
Visione-linguaggio-azione Deposito
 Ricerca
Emma-X: un modello di azione multimodale incarnato con catena di pensiero radicata e ragionamento spaziale lungimirante
Visione-linguaggio-azione Deposito
 Ricerca
FLUX 3 Action fornisce risorse per la modellazione dell'azione mondiale e la previsione dell'azione per robot e simulatori.
Visione-linguaggio-azione Sito web
 Ricerca
Modelli robotici di Google DeepMind che collegano percezione e azione.
Visione-linguaggio-azione Deposito
 Ricerca
HEX è una struttura di visione-linguaggio-azione per tutto il corpo per robot umanoidi a grandezza naturale.
Visione-linguaggio-azione Deposito
 Ricerca
La serie InternVLA-A studia la comprensione, la generazione e l'azione per la manipolazione robotica.
Visione-linguaggio-azioneNOTE SULLA SELEZIONE
Confronta gli input di osservazione, le rappresentazioni delle azioni, le forme di realizzazione supportate e i requisiti di adattamento. Esamina le licenze basate sul peso del modello separatamente dalle licenze del codice e dalle dichiarazioni sui benchmark.
Conosci una risorsa che appartiene a questo posto?