 Référentiel
 Source ouverte
wall-x · X-Square-Robot
Construire des robots à usage général basés sur un modèle de base incorporé
Vision-langage-actionLE RÉPERTOIRE DE L'IA INCORPORÉE
Explorez les ressources du VLA et du modèle de base robotique reliant la perception, les instructions et les actions.
Référentiel
Source ouverte
Construire des robots à usage général basés sur un modèle de base incorporé
Vision-langage-action Référentiel
 Recherche
LingBot-VLA fournit un projet de modèle de fondation vision-langage-action.
Vision-langage-action Référentiel
 Recherche
L'OFAC étudie le conditionnement tourné vers l'avenir pour une adaptation VLA efficace en matière de données.
Vision-langage-action Référentiel
 Recherche
Uni-NaVid : un modèle vision-langage-action basé sur la vidéo pour unifier les tâches de navigation incarnées.
Vision-langage-action Référentiel
 Recherche
Des modèles vision-langage-action à une pile d'apprentissage de robots du monde réel
Vision-langage-action Référentiel
 Recherche
VLA-0 fournit un code de recherche pour créer des modèles vision-langage-action à partir de modèles vision-langage.
Vision-langage-action Référentiel
 Recherche
Green-VLA : modèle vision-langage-action par étapes pour les robots généralistes
Vision-langage-action Référentiel
 Recherche
VLA-RFT fournit des ressources de réglage fin du renforcement pour les modèles vision-langage-action.
Vision-langage-action Référentiel
 Recherche
WholebodyVLA étudie les représentations latentes de VLA pour la locomotion et la manipulation du corps entier.
Vision-langage-action Référentiel
 Recherche
Le référentiel officiel de la première version du modèle de fondation ACE-Brain.
Vision-langage-action Référentiel
 Source ouverte
Le dépôt officiel de l'article : Agentic Robot : A Brain-Inspired Framework for Vision-Language-Action Models in Embodied Agents
Vision-langage-action Référentiel
 Recherche
Anchor-Align étudie le réglage fin du VLA avec l'ancrage de la représentation et l'alignement langage-action.
Vision-langage-action Référentiel
 Recherche
BitVLA implémente des modèles vision-langage-action 1 bit pour la manipulation robotique.
Vision-langage-action Référentiel
 Recherche
CATok étudie la tokenisation des actions causales pour les politiques de robots avec recuit conditionnel dans la correspondance de flux.
Vision-langage-action Référentiel
 Recherche
CLP-VLA fournit un code de réglage fin et d'évaluation axé sur les couches pour les modèles VLA.
Vision-langage-action Référentiel
 Recherche
DEAS Isaac GR00T fournit des ressources de configuration combinant DEAS, Isaac GR00T et RoboCasa.
Vision-langage-action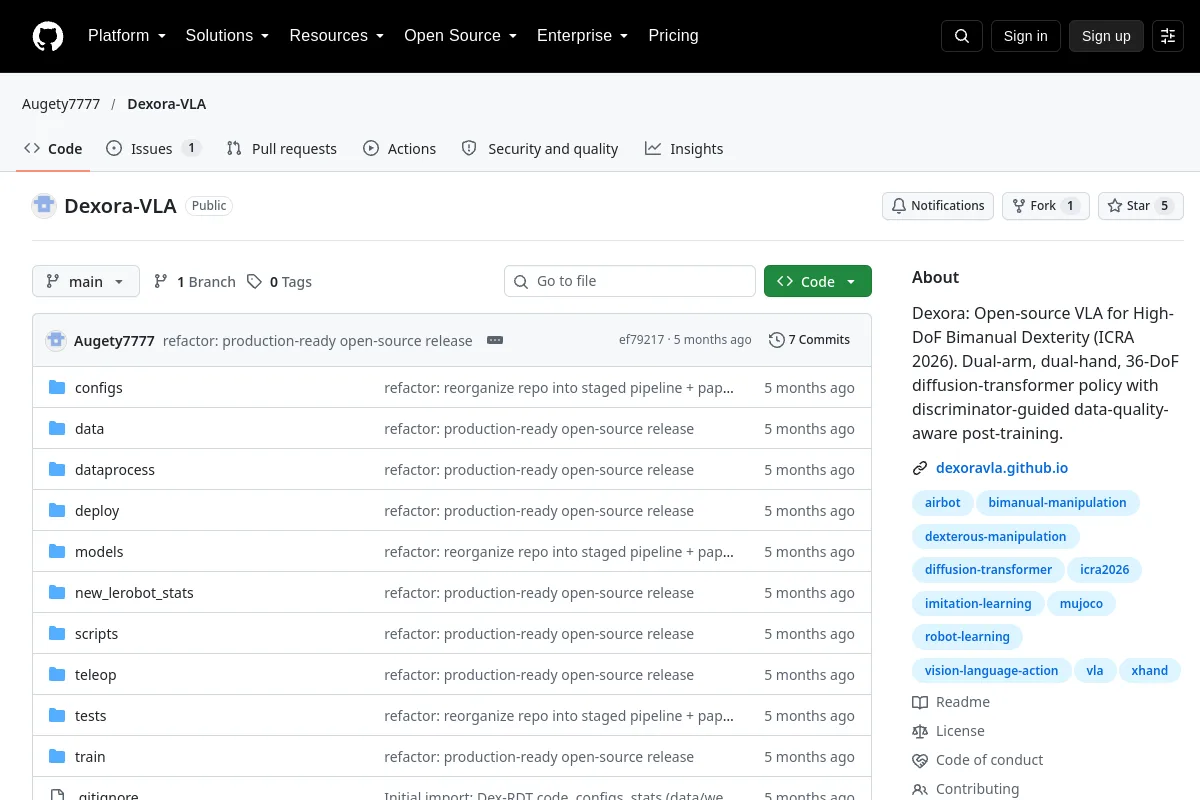 Référentiel
 Recherche
Dexora fournit des ressources politiques VLA pour une dextérité bimanuelle à haut degré de liberté.
Vision-langage-action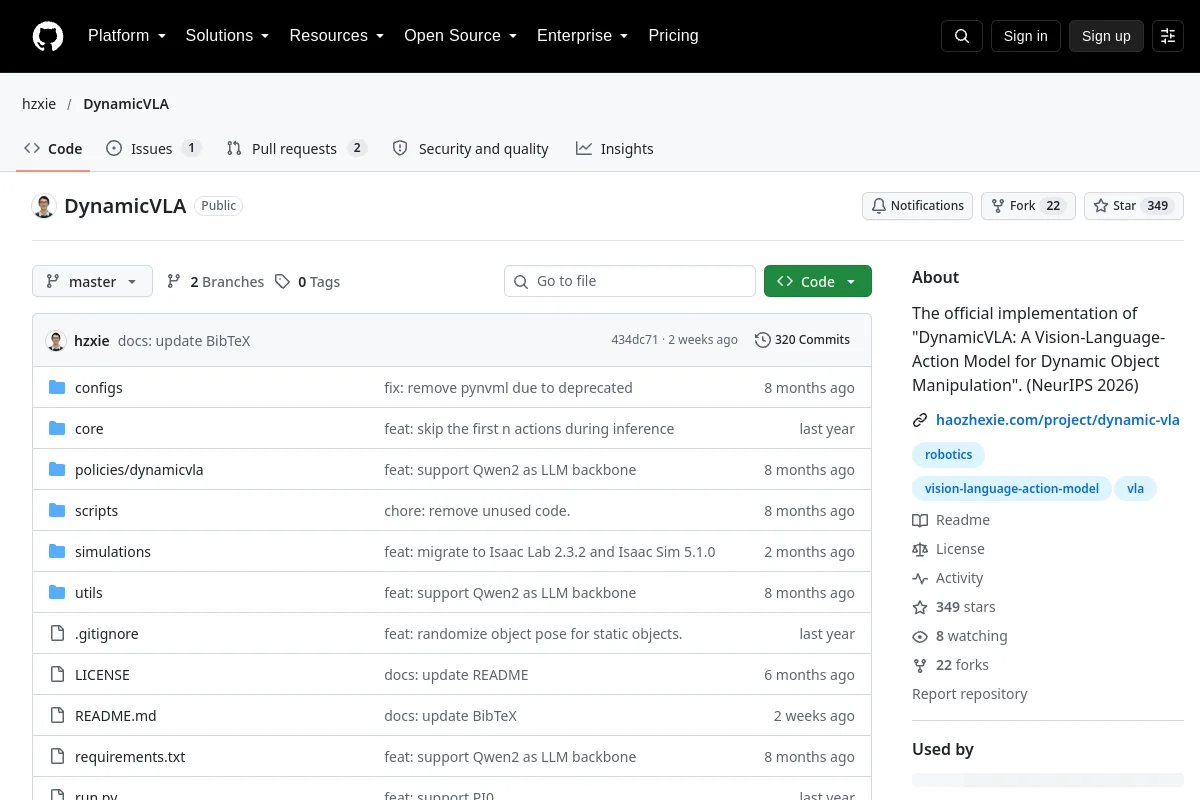 Référentiel
 Recherche
DynamicVLA fournit des ressources de recherche pour la manipulation robotique d'objets dynamiques.
Vision-langage-action Référentiel
 Recherche
Le projet EAI2025 combine le mappage sémantique 3D et le déploiement de VLA pour la manipulation.
Vision-langage-action Référentiel
 Recherche
Emma-X : un modèle d'action multimodal incarné avec une chaîne de pensée fondée et un raisonnement spatial prospectif
Vision-langage-action Référentiel
 Recherche
FLUX 3 Action fournit des ressources de modélisation et de prédiction d'action mondiale pour les robots et les simulateurs.
Vision-langage-action Site Web
 Recherche
Modèles robotiques Google DeepMind reliant la perception et l'action.
Vision-langage-action Référentiel
 Recherche
HEX est un cadre vision-langage-action du corps entier pour les robots humanoïdes de taille réelle.
Vision-langage-action Référentiel
 Recherche
La série InternVLA-A étudie la compréhension, la génération et l'action pour la manipulation robotique.
Vision-langage-actionNOTES DE SÉLECTION
Comparez les entrées d'observation, les représentations d'actions, les modes de réalisation pris en charge et les exigences d'adaptation. Examinez les licences de poids de modèle séparément des licences de code et des revendications de référence.
Connaissez-vous une ressource qui a sa place ici ?