 Förvar
 Öppen källkod
wall-x · X-Square-Robot
Bygga robotar för allmänt bruk baserade på Embodied Foundation Model
Vision-språk-handlingTHE EMBODIED AI DIRECTORY
Utforska VLA och robotbaserade grundmodellresurser som kopplar samman perception, instruktioner och åtgärder.
Förvar
Öppen källkod
Bygga robotar för allmänt bruk baserade på Embodied Foundation Model
Vision-språk-handling Förvar
 Forskning
LingBot-VLA tillhandahåller ett vision-språk-action-grundmodell-projekt.
Vision-språk-handling Förvar
 Forskning
FOCA studerar framtidsorienterad konditionering för dataeffektiv VLA-anpassning.
Vision-språk-handling Förvar
 Forskning
Uni-NaVid: En videobaserad Vision-Language-Action Model för att förena förkroppsligade navigeringsuppgifter.
Vision-språk-handling Förvar
 Forskning
Från vision-språk-handlingsmodeller till en verklig robotinlärningsstapel
Vision-språk-handling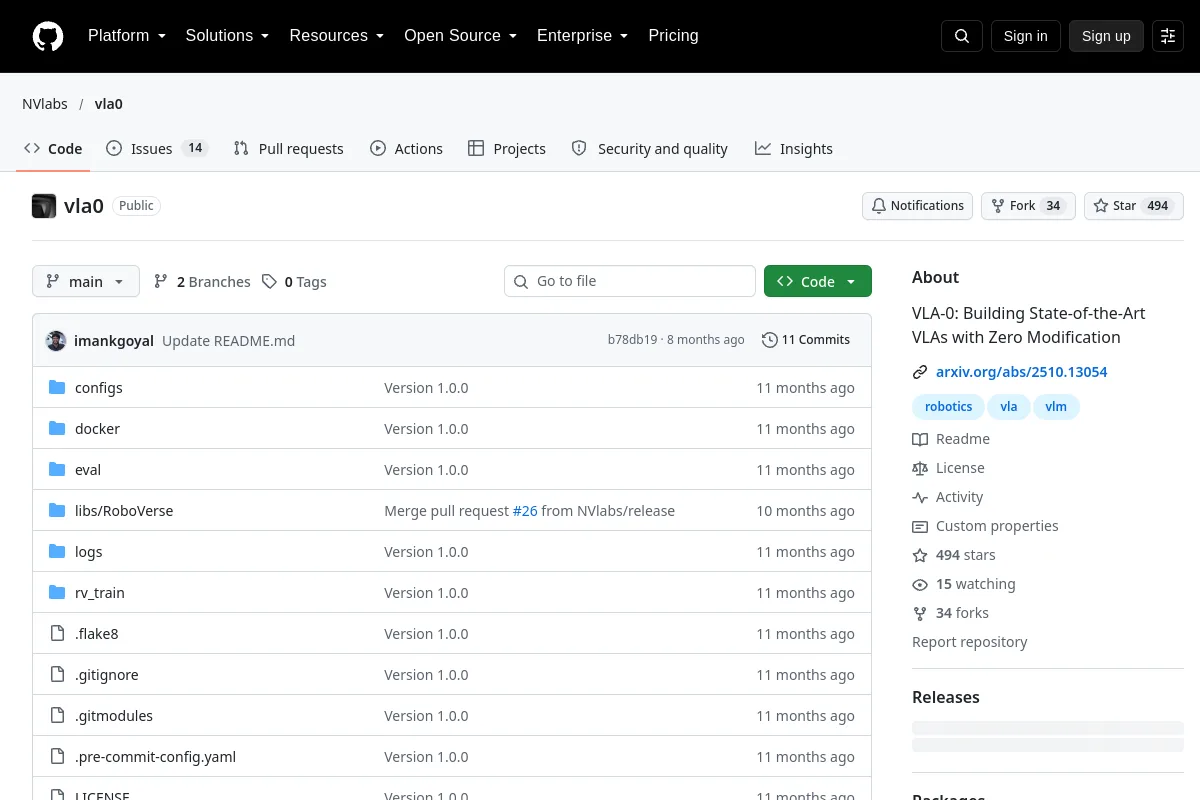 Förvar
 Forskning
VLA-0 tillhandahåller forskningskod för att bygga vision-språk-action-modeller från vision-språk-modeller.
Vision-språk-handling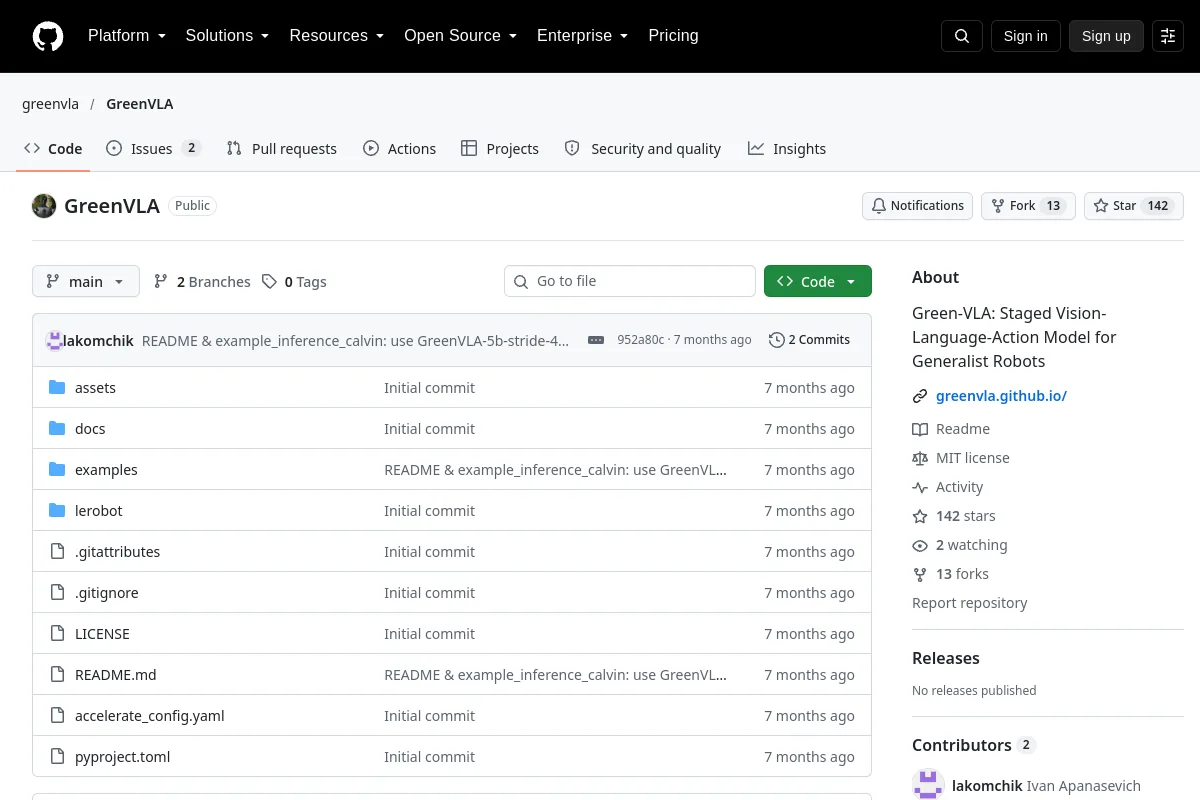 Förvar
 Forskning
Green-VLA: iscensatt vision-språk-handlingsmodell för generalistrobotar
Vision-språk-handling Förvar
 Forskning
VLA-RFT tillhandahåller förstärkande finjusteringsresurser för vision-språk-action-modeller.
Vision-språk-handling Förvar
 Forskning
WholebodyVLA studerar latenta VLA-representationer för rörelse och manipulation av hela kroppen.
Vision-språk-handling Förvar
 Forskning
Det officiella arkivet för den första versionen av ACE-Brain-grundmodellen.
Vision-språk-handling Förvar
 Öppen källkod
Det officiella förrådet för papper: Agentic Robot: A Brain-Inspired Framework for Vision-Language-Action Models in Embodied Agents
Vision-språk-handling Förvar
 Forskning
Anchor-Align studerar VLA-finjustering med representationsförankring och språkhandlingsanpassning.
Vision-språk-handling Förvar
 Forskning
BitVLA implementerar 1-bitars vision-språk-action-modeller för robotmanipulation.
Vision-språk-handling Förvar
 Forskning
CATok studerar kausal handlingstokenisering för robotpolicyer med villkorad glödgning i flödesmatchning.
Vision-språk-handling Förvar
 Forskning
CLP-VLA tillhandahåller lagerfokuserad finjustering och utvärderingskod för VLA-modeller.
Vision-språk-handling Förvar
 Forskning
DEAS Isaac GR00T tillhandahåller installationsresurser som kombinerar DEAS, Isaac GR00T och RoboCasa.
Vision-språk-handling Förvar
 Forskning
Dexora tillhandahåller VLA-policyresurser för bimanuell skicklighet med hög frihetsgrad.
Vision-språk-handling Förvar
 Forskning
DynamicVLA tillhandahåller forskningsresurser för robotmanipulation med dynamiska objekt.
Vision-språk-handling Förvar
 Forskning
EAI2025 Project kombinerar 3D semantisk kartläggning och VLA-distribution för manipulation.
Vision-språk-handling Förvar
 Forskning
Emma-X: An Embodied Multimodal Action Model with Grounded Chain of Thought och Look-ahead Spatial Reasoning
Vision-språk-handling Förvar
 Forskning
FLUX 3 Action tillhandahåller resurser för modellering och handlingsförutsägelse för robotar och simulatorer.
Vision-språk-handling Webbplats
 Forskning
Google DeepMind robotmodeller som kopplar samman perception och handling.
Vision-språk-handling Förvar
 Forskning
HEX är en helkroppsvision-språk-handlingsram för mänskliga robotar i full storlek.
Vision-språk-handling Förvar
 Forskning
InternVLA-A-serien studerar förståelse, generering och handling för robotmanipulation.
Vision-språk-handlingURVALSANMÄRKNINGAR
Jämför observationsingångar, handlingsrepresentationer, understödda utföranden och anpassningskrav. Granska modellviktslicenser separat från kodlicenser och benchmarkanspråk.
Vet du en resurs som hör hemma här?