 Repository
 Research
MemoryVLA · shihao1895
Code of "MemoryVLA: Perceptual-Cognitive Memory in Vision-Language-Action Models for Robotic Manipulation"
Vision-language-actionTHE EMBODIED AI DIRECTORY
Explore VLA and robotic foundation-model resources connecting perception, instructions and actions.
Repository
Research
Code of "MemoryVLA: Perceptual-Cognitive Memory in Vision-Language-Action Models for Robotic Manipulation"
Vision-language-action Repository
 Research
MobileVLA-R1: Reinforcing Vision-Language-Action for Mobile Robots
Vision-language-action Repository
 Research
OmniVLA provides training and inference code for multimodal robot navigation.
Vision-language-action Repository
 Research
OpenDM provides an open-world foundation-model research project for embodied intelligence.
Vision-language-action Repository
 Research
Openpi Dexterous studies pi0 LoRA adaptation for Shadow Hand manipulation and reports experimental limitations.
Vision-language-action Repository
 Research
Open Pi Zero is a reimplementation of Physical Intelligence's pi0 VLA model.
Vision-language-action Repository
 Research
OpenVLA Reproduction documents setup and evaluation of OpenVLA on LIBERO tasks.
Vision-language-action Repository
 Research
O-VLA studies VLA transfer through semantic primitive learning.
Vision-language-action Repository
 Research
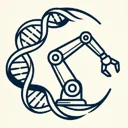
Official implementation of ReconVLA: Reconstructive Vision-Language-Action Model as Effective Robot Perceiver.
Vision-language-action Repository
 Research
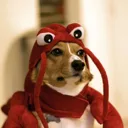
Official repo of Exploring the Adversarial Vulnerabilities of Vision-Language-Action Models in Robotics
Vision-language-action Repository
 Research
Native-video memory for vision-language-action models, using timestamped visual history and exact streaming inference for long-horizon robot manipulation.
Vision-language-action Repository
 Research
Spirit-v1.5: A Robotic Foundation Model by Spirit AI
Vision-language-action Repository
 Research
VIRENA demonstrates a small VLA policy on ManiSkill PickCube with LeRobot integration resources.
Vision-language-action Repository
 Research
VITRA: Scalable Vision-Language-Action Model Pretraining for Robotic Manipulation with Real-Life Human Activity Videos
Vision-language-action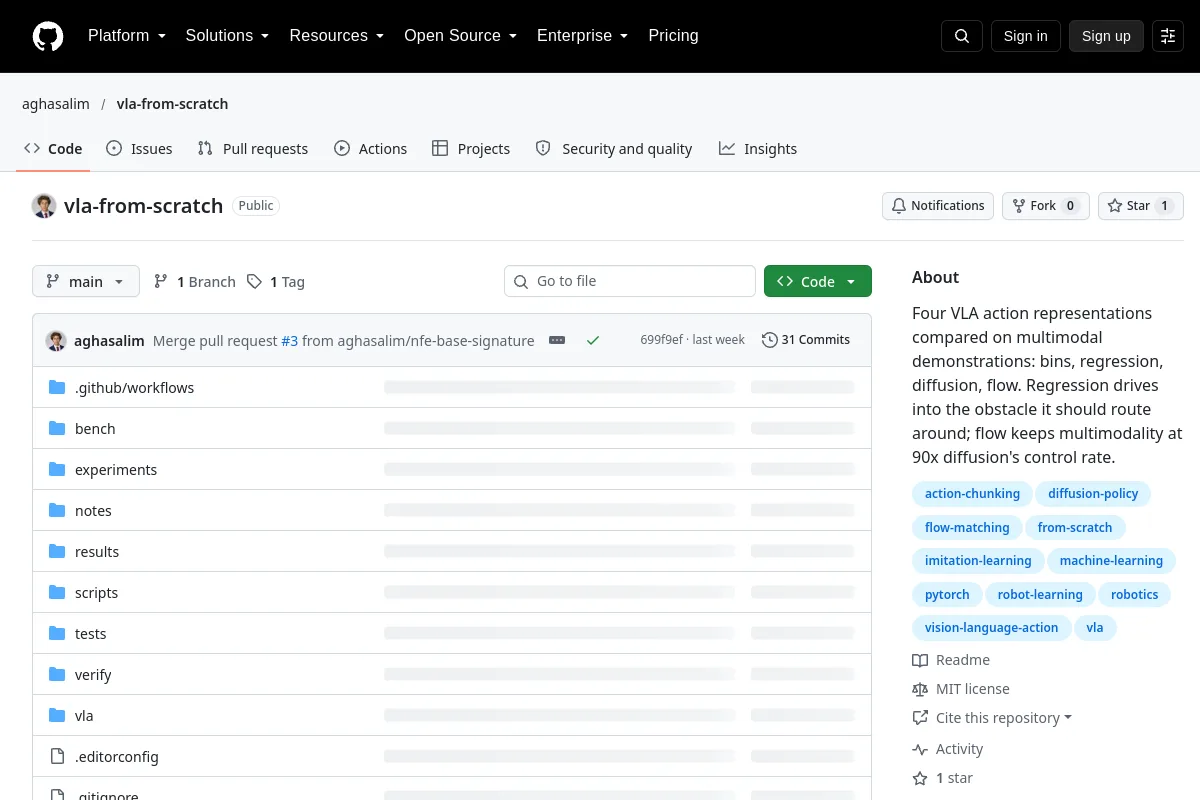 Repository
 Research
VLA From Scratch compares action representations on multimodal demonstrations and obstacle-routing tasks.
Vision-language-action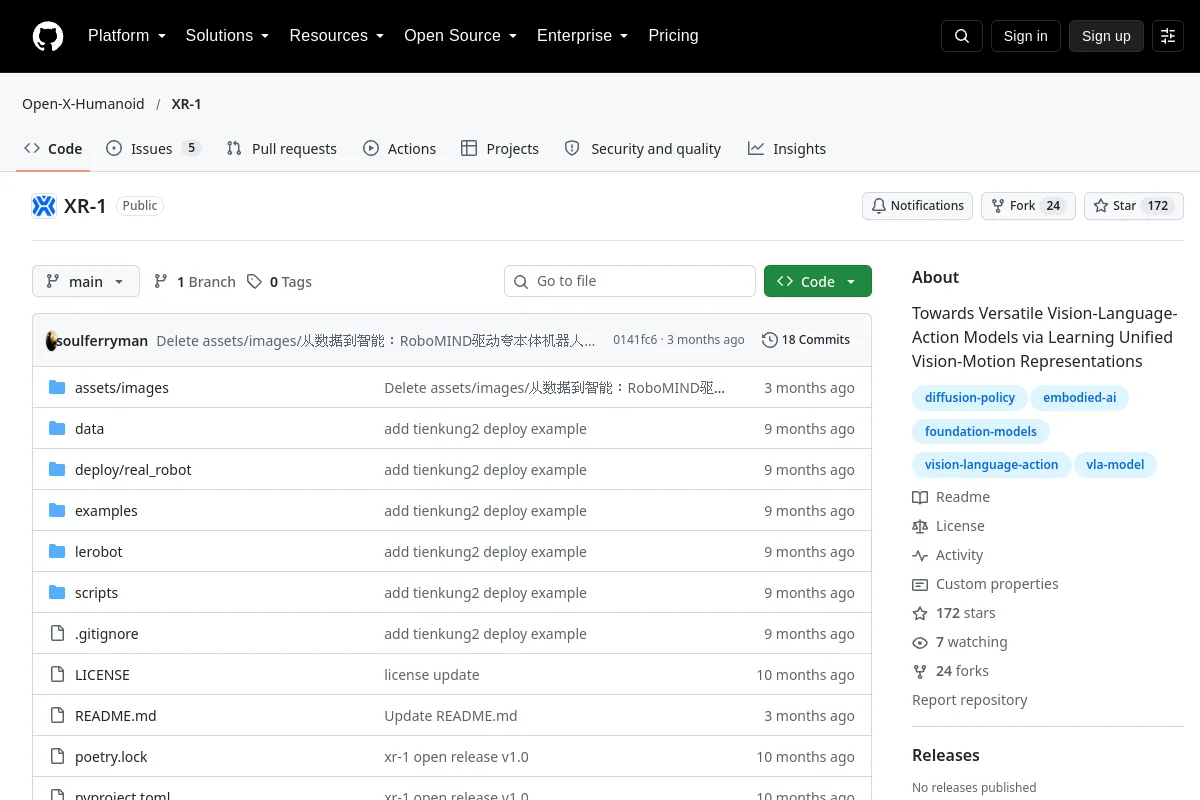 Repository
 Research
Towards Versatile Vision-Language-Action Models via Learning Unified Vision-Motion Representations
Vision-language-action Website
 Research
A vision-language-action research model for robot manipulation.
Vision-language-action Website
SELECTION NOTES
Compare observation inputs, action representations, supported embodiments and adaptation requirements. Review model-weight licenses separately from code licenses and benchmark claims.
Know a resource that belongs here?
