 Deposito
 Ricerca
MemoryVLA · shihao1895
Codice di "MemoryVLA: memoria percettivo-cognitiva in modelli di visione-linguaggio-azione per la manipolazione robotica"
Visione-linguaggio-azioneLA DIRECTORY DELL'AI INCORPORATA
Esplora VLA e le risorse del modello di base robotico che collegano percezione, istruzioni e azioni.
Deposito
Ricerca
Codice di "MemoryVLA: memoria percettivo-cognitiva in modelli di visione-linguaggio-azione per la manipolazione robotica"
Visione-linguaggio-azione Deposito
 Ricerca
MobileVLA-R1: Rafforzare visione-linguaggio-azione per robot mobili
Visione-linguaggio-azione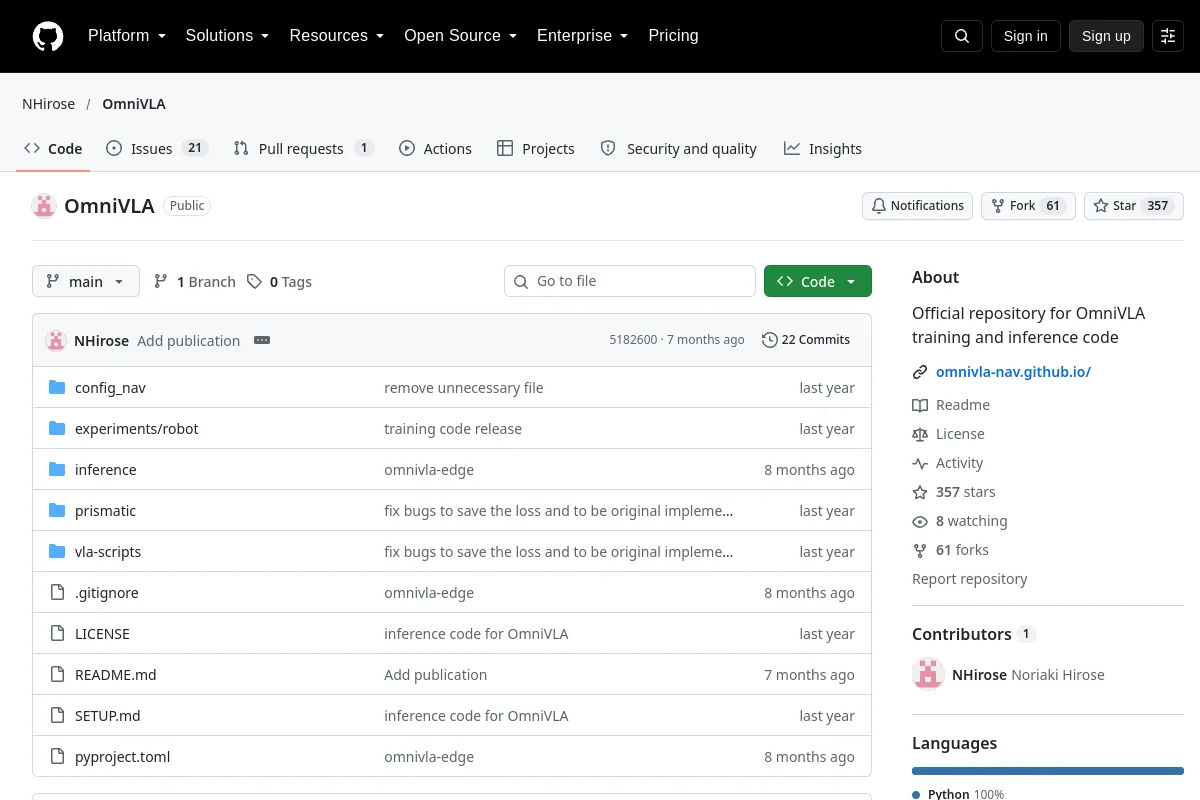 Deposito
 Ricerca
OmniVLA fornisce codice di addestramento e inferenza per la navigazione robot multimodale.
Visione-linguaggio-azione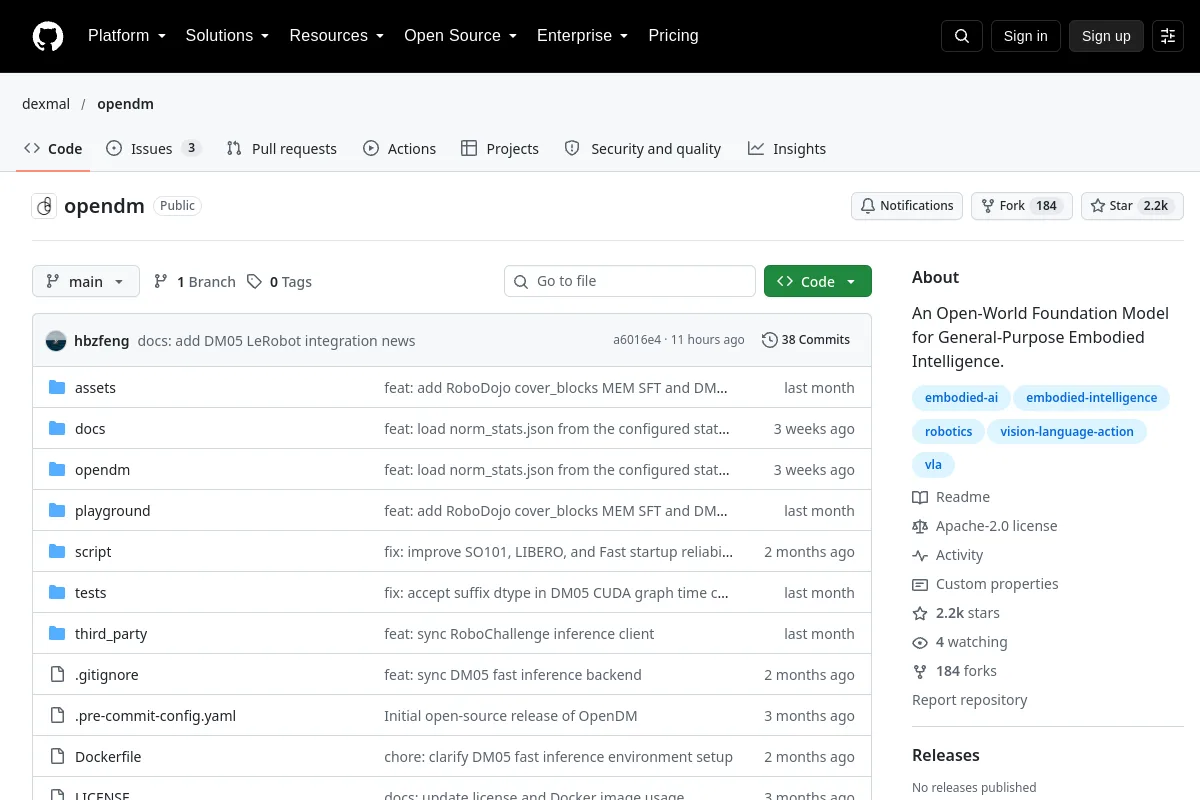 Deposito
 Ricerca
OpenDM fornisce un progetto di ricerca basato su un modello di base open-world per l'intelligenza incarnata.
Visione-linguaggio-azione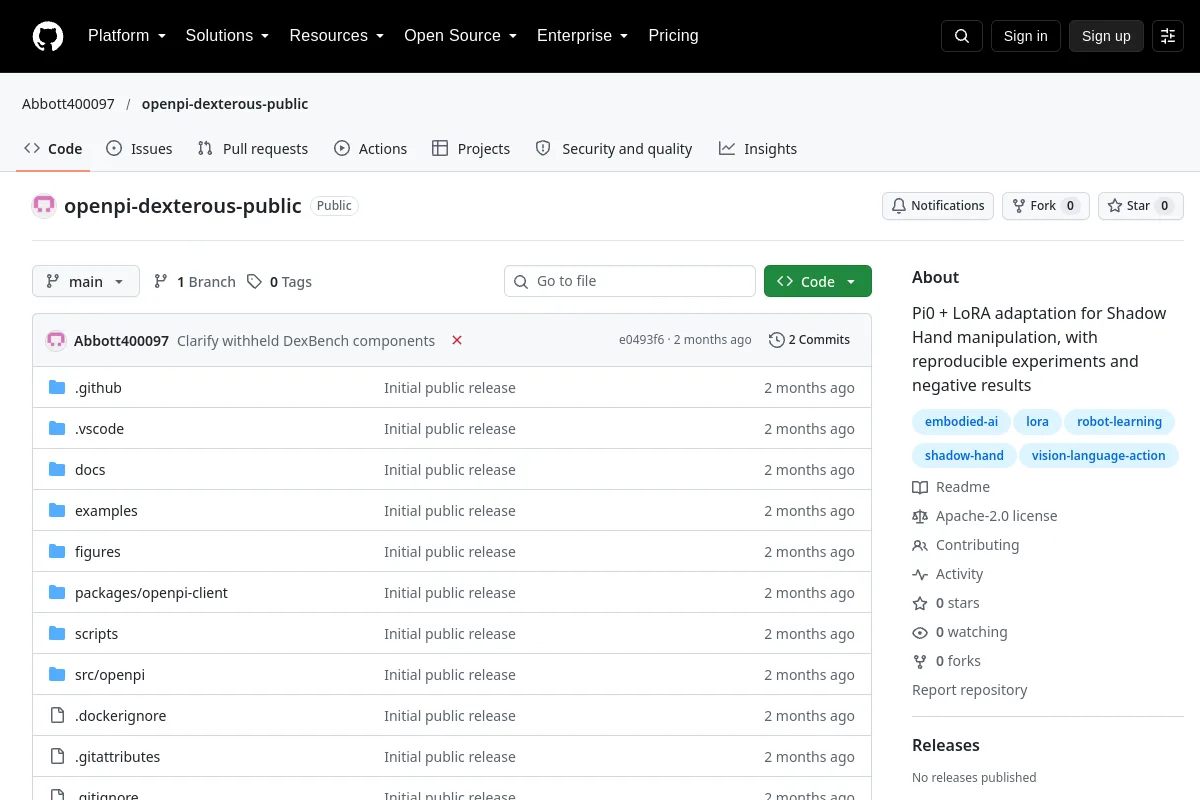 Deposito
 Ricerca
Openpi Dexterous studia l'adattamento di pi0 LoRA per la manipolazione di Shadow Hand e segnala le limitazioni sperimentali.
Visione-linguaggio-azione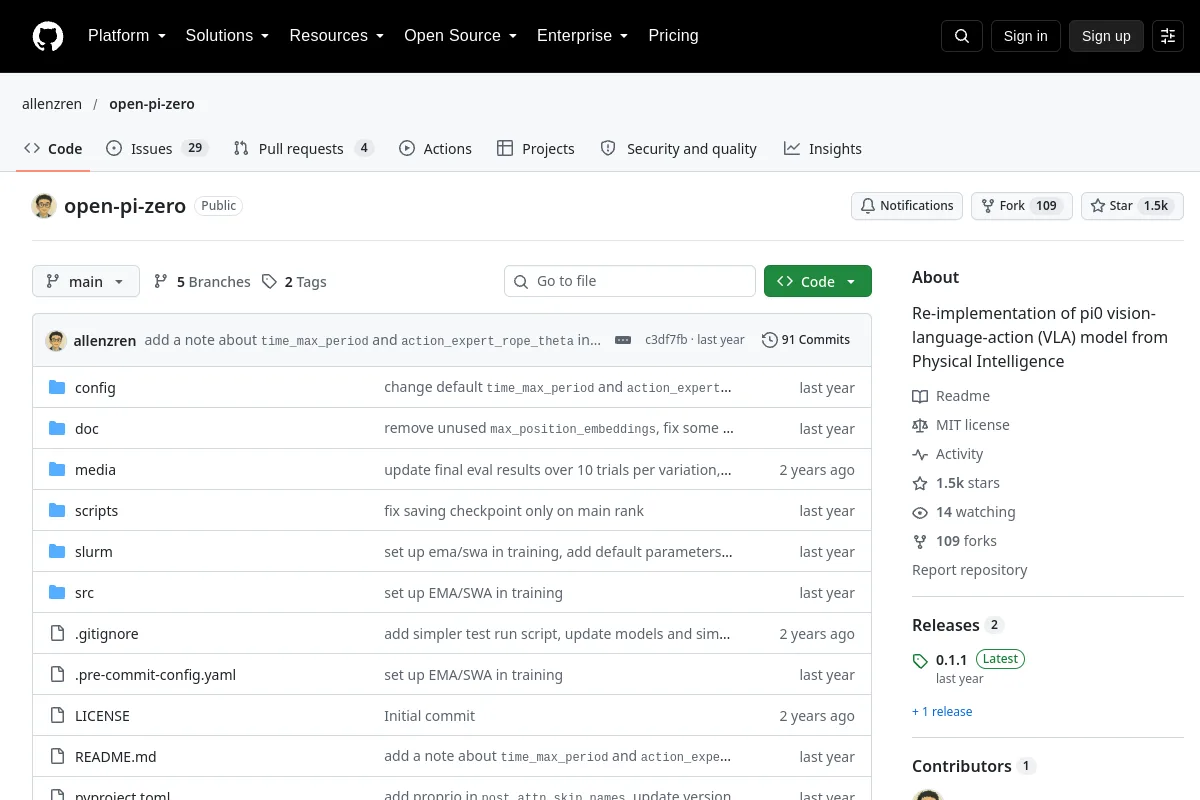 Deposito
 Ricerca
Open Pi Zero è una reimplementazione del modello pi0 VLA di Physical Intelligence.
Visione-linguaggio-azione Deposito
 Ricerca
OpenVLA La riproduzione documenta l'impostazione e la valutazione di OpenVLA sulle attività LIBERO.
Visione-linguaggio-azione Deposito
 Ricerca
O-VLA studia il trasferimento VLA attraverso l'apprendimento primitivo semantico.
Visione-linguaggio-azione Deposito
 Ricerca
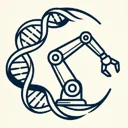
Implementazione ufficiale di ReconVLA: modello ricostruttivo di visione-linguaggio-azione come robot percettivo efficace.
Visione-linguaggio-azione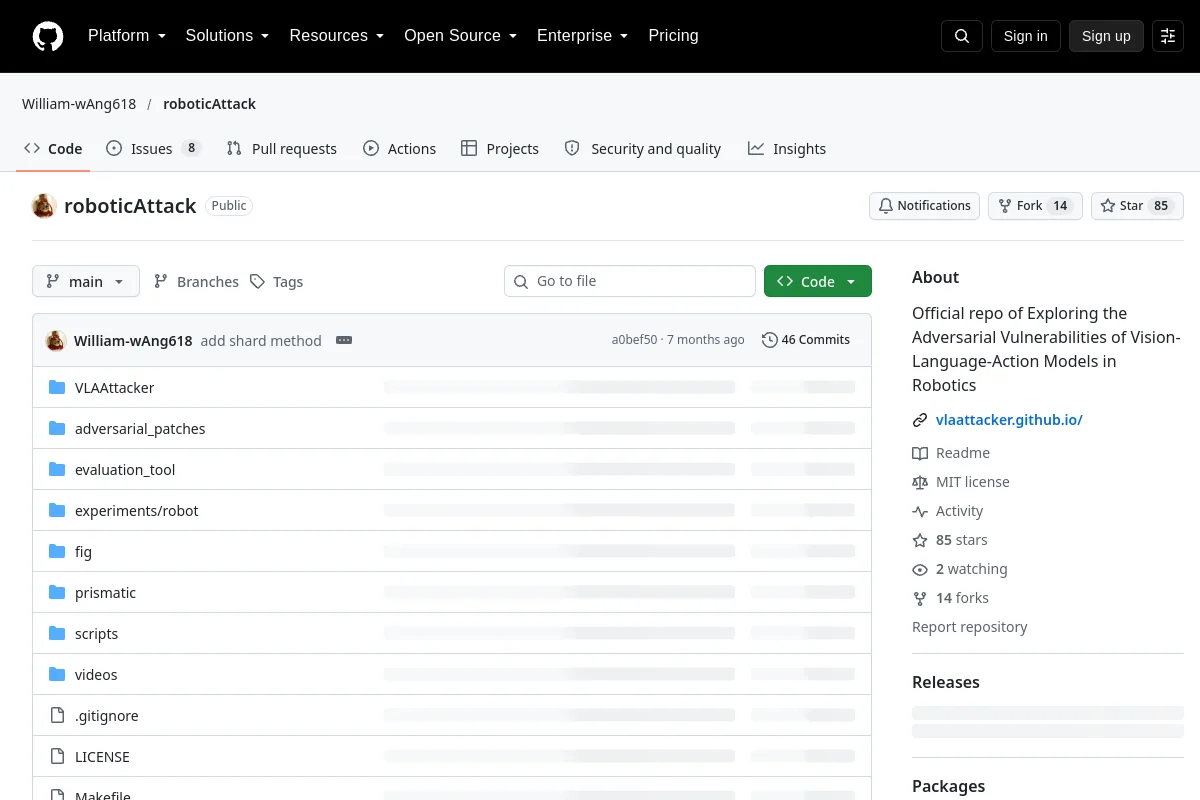 Deposito
 Ricerca
Repo ufficiale di Exploring the Adversarial Vulnerabilities of Vision-Language-Action Models in Robotics
Visione-linguaggio-azione Deposito
 Ricerca
Memoria video nativa per modelli di visione-linguaggio-azione, utilizzando cronologia visiva con timestamp e inferenza di streaming esatta per la manipolazione di robot a lungo orizzonte.
Visione-linguaggio-azione Deposito
 Ricerca
Spirit-v1.5: un modello di base robotica di Spirit AI
Visione-linguaggio-azione Deposito
 Ricerca
VIRENA dimostra una piccola politica VLA su ManiSkill PickCube con le risorse di integrazione LeRobot.
Visione-linguaggio-azione Deposito
 Ricerca
VITRA: Preformazione del modello scalabile visione-linguaggio-azione per la manipolazione robotica con video di attività umane nella vita reale
Visione-linguaggio-azione Deposito
 Ricerca
VLA From Scratch confronta le rappresentazioni delle azioni su dimostrazioni multimodali e attività di superamento degli ostacoli.
Visione-linguaggio-azione Deposito
 Ricerca
Verso modelli versatili di visione-linguaggio-azione attraverso l'apprendimento di rappresentazioni unificate di visione-movimento
Visione-linguaggio-azione Sito web
 Ricerca
Un modello di ricerca visione-linguaggio-azione per la manipolazione di robot.
Visione-linguaggio-azione Sito web
NOTE SULLA SELEZIONE
Confronta gli input di osservazione, le rappresentazioni delle azioni, le forme di realizzazione supportate e i requisiti di adattamento. Esamina le licenze basate sul peso del modello separatamente dalle licenze del codice e dalle dichiarazioni sui benchmark.
Conosci una risorsa che appartiene a questo posto?
