 Repositorio
 Investigación
MemoryVLA · shihao1895
Código de "MemoryVLA: Memoria Perceptivo-Cognitiva en Modelos Visión-Lenguaje-Acción para Manipulación Robótica"
Visión-lenguaje-acciónEL DIRECTORIO DE IA INCORPORADO
Explore VLA y recursos de modelos básicos robóticos que conectan percepción, instrucciones y acciones.
Repositorio
Investigación
Código de "MemoryVLA: Memoria Perceptivo-Cognitiva en Modelos Visión-Lenguaje-Acción para Manipulación Robótica"
Visión-lenguaje-acción Repositorio
 Investigación
MobileVLA-R1: refuerzo de visión-lenguaje-acción para robots móviles
Visión-lenguaje-acción Repositorio
 Investigación
OmniVLA proporciona código de inferencia y capacitación para la navegación de robots multimodal.
Visión-lenguaje-acción Repositorio
 Investigación
OpenDM proporciona un proyecto de investigación de modelo básico de mundo abierto para la inteligencia incorporada.
Visión-lenguaje-acción Repositorio
 Investigación
Openpi Dexterous estudia la adaptación de pi0 LoRA para la manipulación de Shadow Hand e informa limitaciones experimentales.
Visión-lenguaje-acción Repositorio
 Investigación
Open Pi Zero es una reimplementación del modelo pi0 VLA de Physical Intelligence.
Visión-lenguaje-acción Repositorio
 Investigación
OpenVLA Configuración y evaluación de documentos de reproducción de OpenVLA en tareas LIBERO.
Visión-lenguaje-acción Repositorio
 Investigación
O-VLA estudia la transferencia de VLA mediante el aprendizaje semántico primitivo.
Visión-lenguaje-acción Repositorio
 Investigación
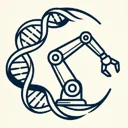
Implementación oficial de ReconVLA: Modelo Reconstructivo de Visión-Lenguaje-Acción como Perceptor Robótico Eficaz.
Visión-lenguaje-acción Repositorio
 Investigación
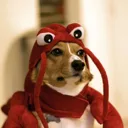
Repositorio oficial de Exploración de las vulnerabilidades adversas de los modelos de visión-lenguaje-acción en robótica
Visión-lenguaje-acción Repositorio
 Investigación
Memoria de video nativa para modelos de visión, lenguaje y acción, que utiliza un historial visual con marca de tiempo e inferencia de transmisión exacta para la manipulación de robots a largo plazo.
Visión-lenguaje-acción Repositorio
 Investigación
Spirit-v1.5: un modelo de base robótica de Spirit AI
Visión-lenguaje-acción Repositorio
 Investigación
VIRENA demuestra una pequeña política de VLA en ManiSkill PickCube con recursos de integración LeRobot.
Visión-lenguaje-acción Repositorio
 Investigación
VITRA: Entrenamiento previo del modelo escalable de visión, lenguaje y acción para manipulación robótica con videos de actividades humanas de la vida real
Visión-lenguaje-acción Repositorio
 Investigación
VLA From Scratch compara representaciones de acciones en demostraciones multimodales y tareas de trazado de obstáculos.
Visión-lenguaje-acción Repositorio
 Investigación
Hacia modelos versátiles de visión-lenguaje-acción mediante el aprendizaje de representaciones unificadas de visión-movimiento
Visión-lenguaje-acción Sitio web
 Investigación
Un modelo de investigación visión-lenguaje-acción para la manipulación de robots.
Visión-lenguaje-acción Sitio web
NOTAS DE SELECCIÓN
Compare entradas de observación, representaciones de acciones, realizaciones admitidas y requisitos de adaptación. Revise las licencias de peso de modelo por separado de las licencias de código y las afirmaciones de referencia.
¿Conoce algún recurso que pertenezca aquí?
