 Repository
 Forschung
JanusVLN · MIV-XJTU
JanusVLN untersucht die visuelle Sprachnavigation mit separatem semantischen und räumlichen Gedächtnis.
Vision-Sprache-AktionDAS VERKÖRPERTE KI-VERZEICHNIS
Entdecken Sie Vision-Sprach-Aktionsmodelle und Robotik-Grundlagenmodelle mit offiziellen Projektlinks.
Repository
Forschung
JanusVLN untersucht die visuelle Sprachnavigation mit separatem semantischen und räumlichen Gedächtnis.
Vision-Sprache-Aktion Repository
 Forschung
Code of Paper „KERV: Kinematic-Rectified Speculative Decoding for Embodied VLA Models“, akzeptiert von DAC 2026.
Vision-Sprache-Aktion Repository
 Forschung
LaST$_0$: Latente räumlich-zeitliche Gedankenkette für das Roboter-Vision-Sprach-Aktionsmodell
Vision-Sprache-Aktion Repository
 Forschung
Code von „MemoryVLA: Perceptual-Cognitive Memory in Vision-Language-Action Models for Robotic Manipulation“
Vision-Sprache-Aktion Repository
 Forschung
MobileVLA-R1: Stärkung der Bild-Sprach-Aktion für mobile Roboter
Vision-Sprache-Aktion Repository
 Forschung
OmniVLA bietet Trainings- und Inferenzcode für die multimodale Roboternavigation.
Vision-Sprache-Aktion Repository
 Forschung
OpenDM bietet ein Open-World-Grundmodell-Forschungsprojekt für verkörperte Intelligenz.
Vision-Sprache-Aktion Repository
 Forschung
Openpi Dexterous untersucht die pi0-LoRA-Anpassung für die Manipulation der Schattenhand und berichtet über experimentelle Einschränkungen.
Vision-Sprache-Aktion Repository
 Forschung
Open Pi Zero ist eine Neuimplementierung des pi0 VLA-Modells von Physical Intelligence.
Vision-Sprache-Aktion Repository
 Forschung
OpenVLA Reproduktion dokumentiert die Einrichtung und Bewertung von OpenVLA für LIBERO-Aufgaben.
Vision-Sprache-Aktion Repository
 Forschung
O-VLA untersucht den VLA-Transfer durch semantisches primitives Lernen.
Vision-Sprache-Aktion Repository
 Open Source
Pelican-VL 1.0 ist eine neue Familie von Open-Source-Modellen des verkörperten Gehirns mit Parameterskalen von 7B bis 72B, die von der WFM System Group, dem Beijing Innovation Center of Humanoid Robotics, entwickelt wurden.
Vision-Sprache-Aktion Repository
 Forschung
Offizielle Implementierung von ReconVLA: Reconstructive Vision-Language-Action Model as Effective Robot Perceiver.
Vision-Sprache-Aktion Repository
 Forschung
Offizielles Repo von Exploring the Adversarial Vulnerabilities of Vision-Language-Action Models in Robotics
Vision-Sprache-Aktion Repository
 Forschung
Nativer Videospeicher für Vision-Sprach-Aktionsmodelle, der einen zeitgestempelten visuellen Verlauf und exakte Streaming-Inferenz für die Manipulation von Robotern mit langem Horizont nutzt.
Vision-Sprache-Aktion Repository
 Forschung
Spirit-v1.5: Ein Roboter-Grundmodell von Spirit AI
Vision-Sprache-Aktion Repository
 Forschung
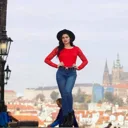
VIRENA demonstriert eine kleine VLA-Richtlinie auf ManiSkill PickCube mit LeRobot-Integrationsressourcen.
Vision-Sprache-Aktion Repository
 Forschung
VITRA: Skalierbares Vision-Sprache-Aktion-Modell-Vortraining für Robotermanipulation mit realen Videos menschlicher Aktivitäten
Vision-Sprache-Aktion Repository
 Forschung
VLA From Scratch vergleicht Aktionsdarstellungen bei multimodalen Demonstrationen und Hindernisrouting-Aufgaben.
Vision-Sprache-Aktion Repository
 Forschung
Auf dem Weg zu vielseitigen Vision-Sprach-Aktionsmodellen durch das Erlernen einheitlicher Vision-Bewegungs-Darstellungen
Vision-Sprache-Aktion Website
 Forschung
Ein Vision-Sprach-Aktions-Forschungsmodell zur Robotermanipulation.
Vision-Sprache-Aktion Website
 Open Source
Ein offenes Vision-Sprach-Aktionsmodell für die Robotermanipulation.
Vision-Sprache-Aktion Website
 Open Source
Ein kompaktes Vision-Sprach-Aktionsmodell im LeRobot-Ökosystem.
Vision-Sprache-Aktion Website
AUSWAHLHINWEISE
Überprüfen Sie unterstützte Beobachtungen und Aktionsdarstellungen, Checkpoint-Lizenzen, Rechenanforderungen und Anpassungsdatensätze. Modellgewichte bieten nicht für jeden Roboter eine fertige Steuerung. Planbewertung in Simulation und kontrollierten Hardwaretests.
Kennen Sie eine Ressource, die hierher gehört?
