 Repository
 Forschung
FOCA · cair-vinuni
Das BAZL untersucht zukunftsorientierte Konditionierung zur dateneffizienten VLA-Anpassung.
Vision-Sprache-AktionDAS VERKÖRPERTE KI-VERZEICHNIS
Entdecken Sie VLA- und Roboterfundamentmodell-Ressourcen, die Wahrnehmung, Anweisungen und Aktionen verbinden.
Repository
Forschung
Das BAZL untersucht zukunftsorientierte Konditionierung zur dateneffizienten VLA-Anpassung.
Vision-Sprache-Aktion Repository
 Forschung
Uni-NaVid: Ein videobasiertes Vision-Sprach-Aktionsmodell zur Vereinheitlichung verkörperter Navigationsaufgaben.
Vision-Sprache-Aktion Repository
 Forschung
Von Vision-Language-Action-Modellen zu einem realen Roboter-Lernstapel
Vision-Sprache-Aktion Repository
 Forschung
VLA-0 stellt Forschungscode zum Erstellen von Vision-Sprach-Aktionsmodellen aus Vision-Sprachmodellen bereit.
Vision-Sprache-Aktion Repository
 Forschung
Green-VLA: Inszeniertes Vision-Sprach-Aktionsmodell für generalistische Roboter
Vision-Sprache-Aktion Repository
 Forschung
VLA-RFT bietet Ressourcen zur Feinabstimmung der Verstärkung für Vision-Sprach-Aktionsmodelle.
Vision-Sprache-Aktion Repository
 Forschung
WholebodyVLA untersucht latente VLA-Darstellungen für die Fortbewegung und Manipulation des gesamten Körpers.
Vision-Sprache-Aktion Repository
 Forschung
Das offizielle Repository der ersten Version des ACE-Brain-Grundlagenmodells.
Vision-Sprache-Aktion Repository
 Forschung
Anchor-Align untersucht die VLA-Feinabstimmung mit Darstellungsverankerung und Sprach-Aktions-Ausrichtung.
Vision-Sprache-Aktion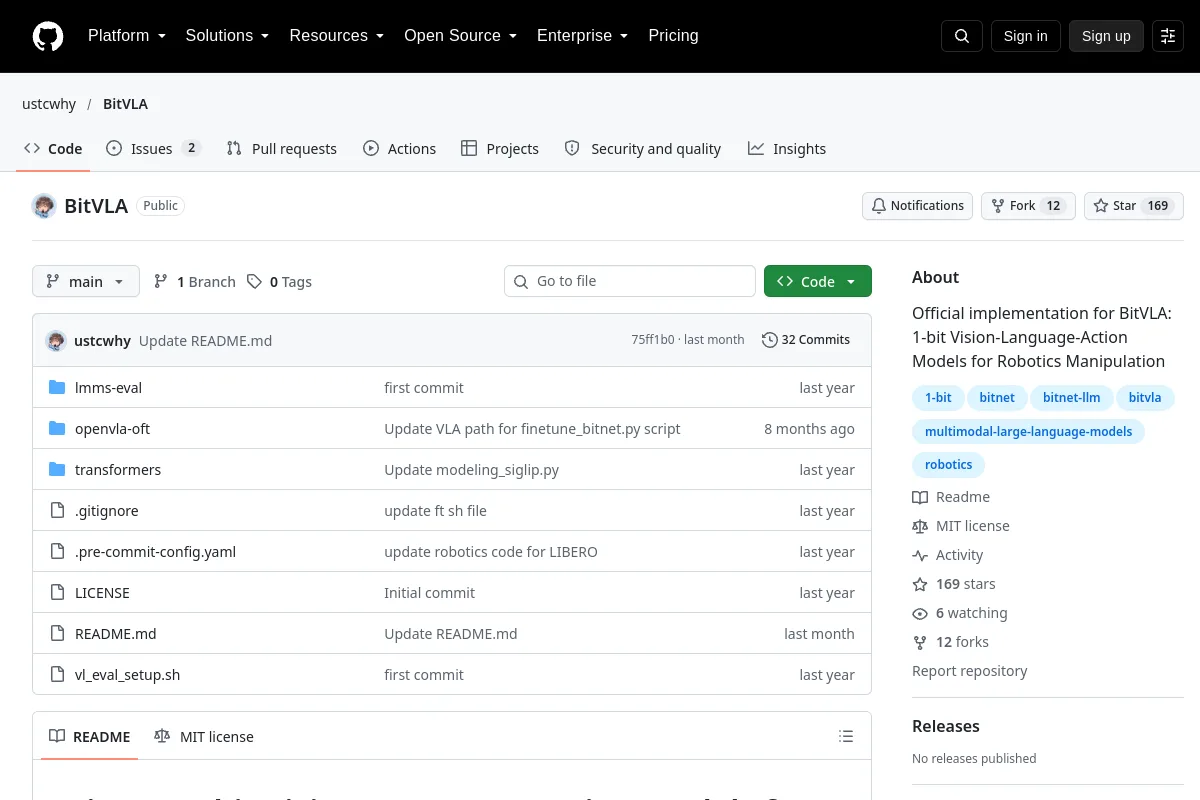 Repository
 Forschung
BitVLA implementiert 1-Bit-Vision-Sprach-Aktionsmodelle für die Robotermanipulation.
Vision-Sprache-Aktion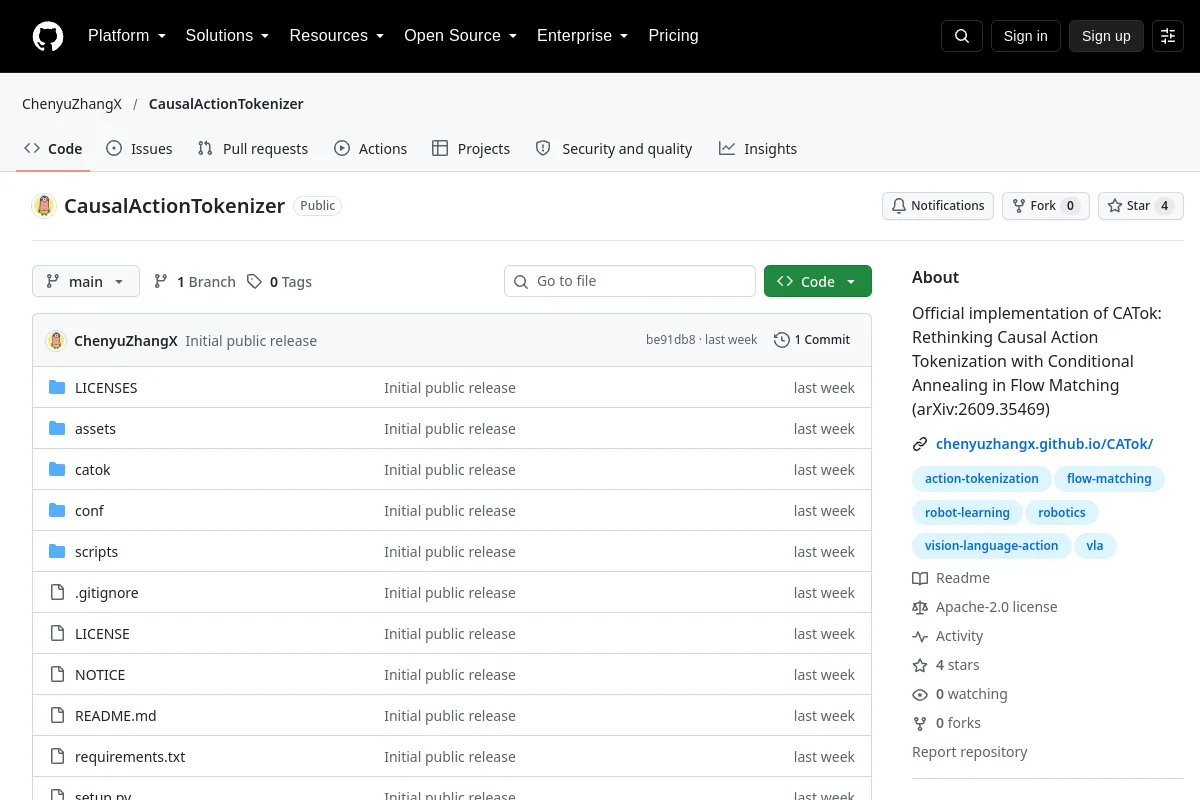 Repository
 Forschung
CATok untersucht die Tokenisierung kausaler Aktionen für Roboterrichtlinien mit bedingtem Annealing beim Flow-Matching.
Vision-Sprache-Aktion Repository
 Forschung
CLP-VLA bietet schichtorientierten Feinabstimmungs- und Evaluierungscode für VLA-Modelle.
Vision-Sprache-Aktion Repository
 Forschung
DEAS Isaac GR00T bietet Einrichtungsressourcen, die DEAS, Isaac GR00T und RoboCasa kombinieren.
Vision-Sprache-Aktion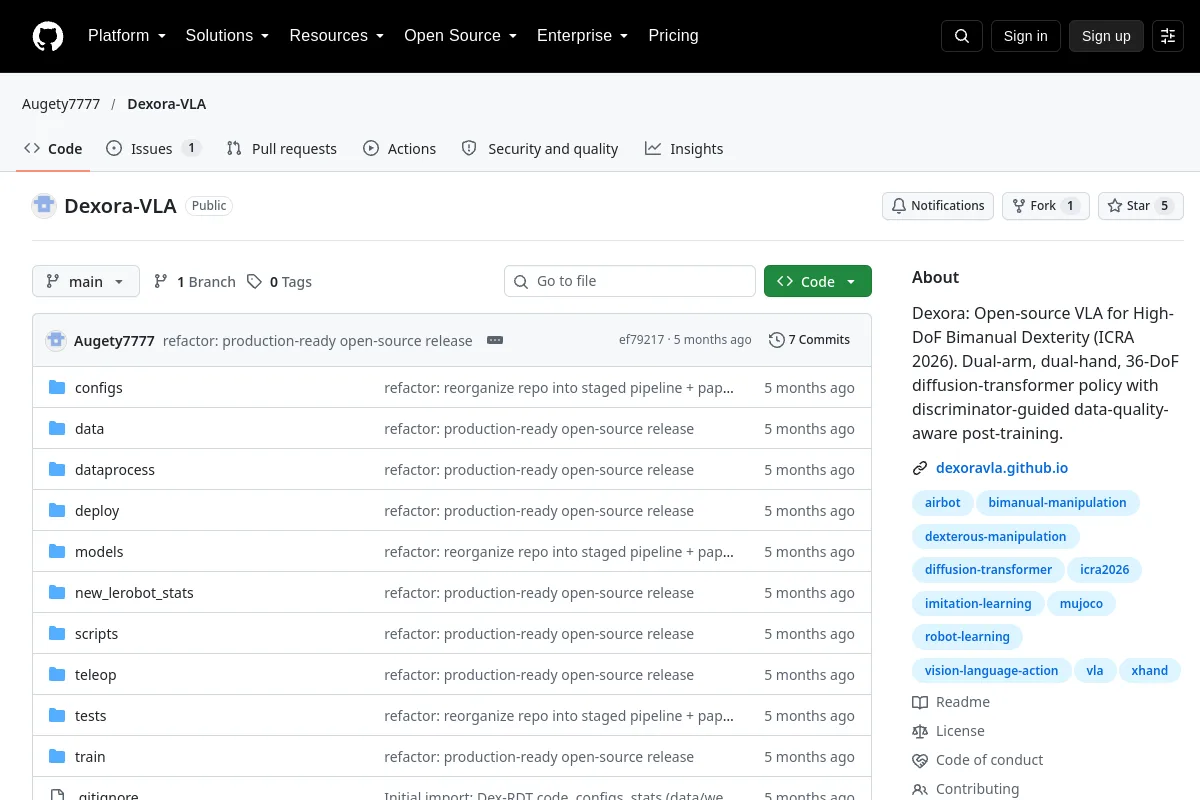 Repository
 Forschung
Dexora stellt VLA-Richtlinienressourcen für bimanuelle Geschicklichkeit mit hohem Freiheitsgrad bereit.
Vision-Sprache-Aktion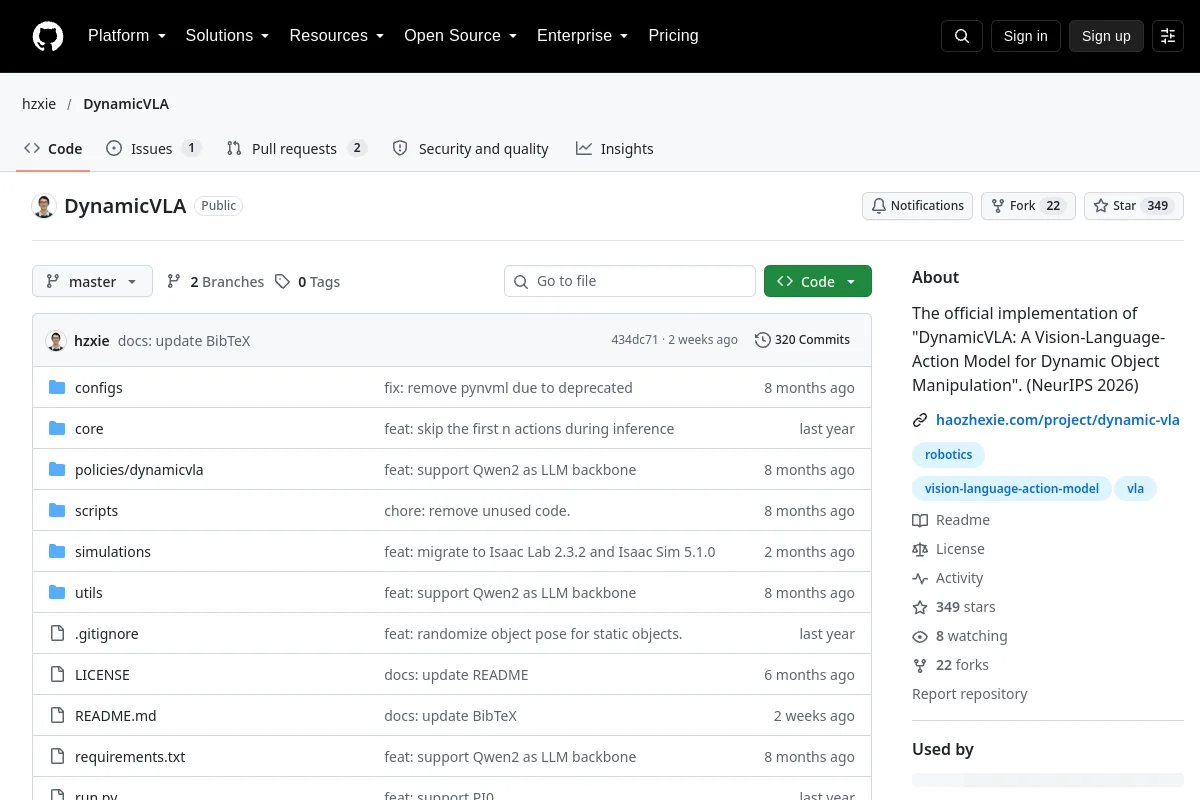 Repository
 Forschung
DynamicVLA bietet Forschungsressourcen für die Robotermanipulation dynamischer Objekte.
Vision-Sprache-Aktion Repository
 Forschung
Das EAI2025-Projekt kombiniert semantische 3D-Zuordnung und VLA-Bereitstellung zur Manipulation.
Vision-Sprache-Aktion Repository
 Forschung
Emma-X: Ein verkörpertes multimodales Aktionsmodell mit fundierter Gedankenkette und vorausschauendem räumlichen Denken
Vision-Sprache-Aktion Repository
 Forschung
FLUX 3 Action bietet Ressourcen zur Weltaktionsmodellierung und Aktionsvorhersage für Roboter und Simulatoren.
Vision-Sprache-Aktion Website
 Forschung
Google DeepMind-Robotikmodelle verbinden Wahrnehmung und Aktion.
Vision-Sprache-Aktion Repository
 Forschung
HEX ist ein Ganzkörper-Vision-Sprach-Aktions-Framework für humanoide Roboter in Originalgröße.
Vision-Sprache-Aktion Repository
 Forschung
Die InternVLA-A-Reihe untersucht das Verständnis, die Entstehung und die Aktion der Robotermanipulation.
Vision-Sprache-Aktion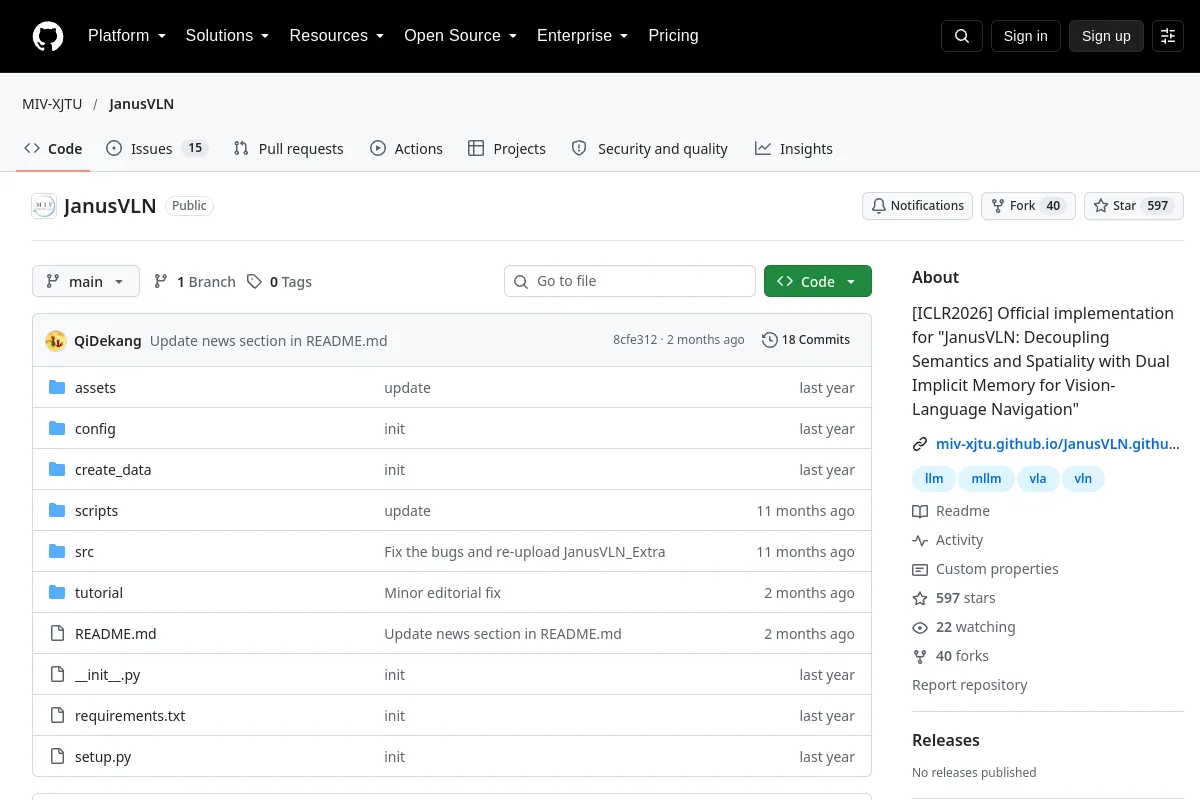 Repository
 Forschung
JanusVLN untersucht die visuelle Sprachnavigation mit separatem semantischen und räumlichen Gedächtnis.
Vision-Sprache-Aktion Repository
 Forschung
Code of Paper „KERV: Kinematic-Rectified Speculative Decoding for Embodied VLA Models“, akzeptiert von DAC 2026.
Vision-Sprache-Aktion Repository
 Forschung
LaST$_0$: Latente räumlich-zeitliche Gedankenkette für das Roboter-Vision-Sprach-Aktionsmodell
Vision-Sprache-AktionAUSWAHLHINWEISE
Vergleichen Sie Beobachtungseingaben, Aktionsdarstellungen, unterstützte Ausführungsformen und Anpassungsanforderungen. Überprüfen Sie Modelllizenzen getrennt von Codelizenzen und Benchmark-Ansprüchen.
Kennen Sie eine Ressource, die hierher gehört?