 Website
 Open Source
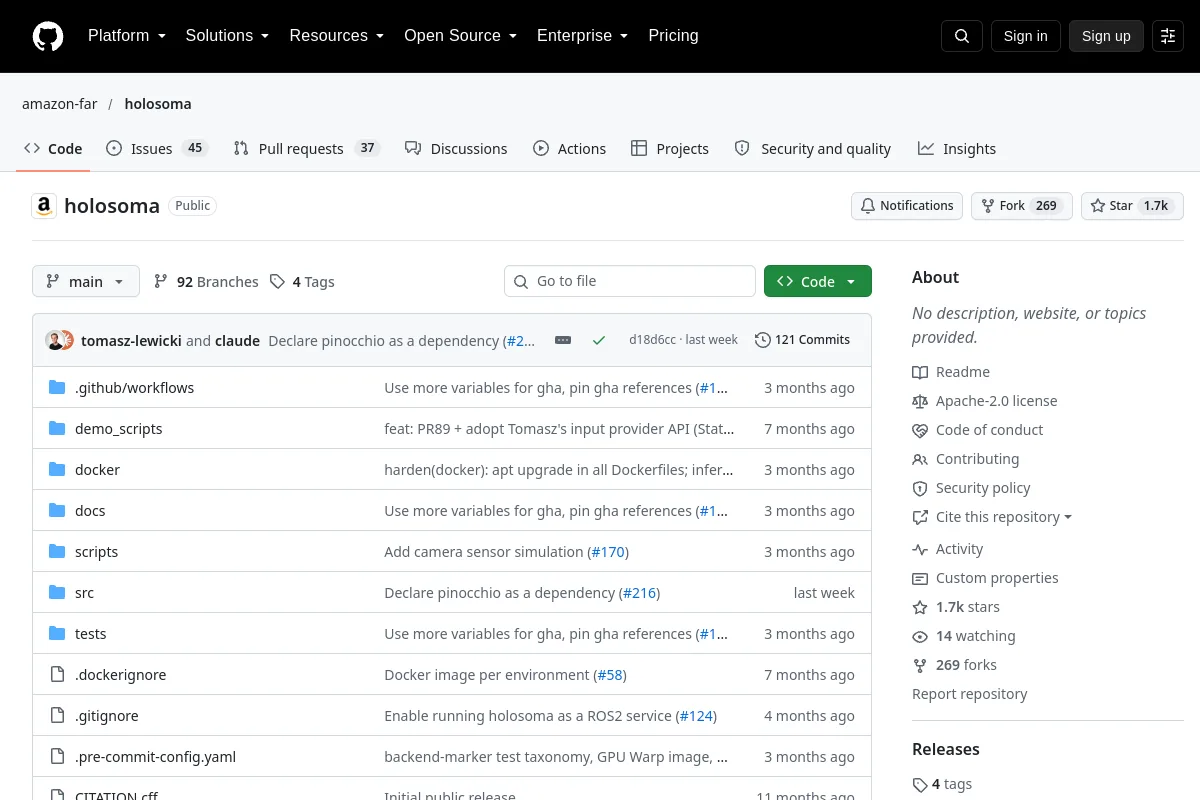
Holosoma
Ein Lernrahmen für humanoide Roboter, der Simulation und Einsatz umfasst.
Frameworks für das Lernen von Robotern
Modelle / Forschung
WholebodyVLA untersucht latente VLA-Darstellungen für die Fortbewegung und Manipulation des gesamten Körpers.

WholebodyVLA untersucht latente VLA-Darstellungen für die Fortbewegung und Manipulation des gesamten Körpers.
Zusammenfassung des Herausgebers: „[ICLR 2026] Towards Unified Latent VLA for Whole-body Loco-manipulation Control“
Verwenden Sie das Repository, um die Implementierung, Dokumentation und unterstützten Arbeitsabläufe zu überprüfen. Dieser Verzeichniseintrag identifiziert den Betreuer, die Codelizenz und zugehörige Ressourcen; Es wird nicht behauptet, dass das Projekt auf Ihrem Roboter installiert oder getestet wurde.
Codelizenzen decken nicht automatisch Modellgewichte, Datensätze oder Hardwaredesigns ab. Nicht erfasste Lizenzdetails bedürfen der Bestätigung durch den Herausgeber.
Website
Open Source
Ein Lernrahmen für humanoide Roboter, der Simulation und Einsatz umfasst.
Frameworks für das Lernen von Robotern Repository
 Open Source
„FALCON: Erlernen der kraftadaptiven humanoiden Lokmanipulation“
Roboterrichtlinien Repository
 Forschung
Offizielle Umsetzung des Papiers: „PhysHSI: Towards a Real-World Generalizable and Natural Humanoid-Scene Interaction System“
Roboterrichtlinien