 Förvar
 Forskning
MemoryVLA · shihao1895
Koden för "MemoryVLA: Perceptual-Kognitive Memory in Vision-Language-Action Models for Robotic Manipulation"
Vision-språk-handlingTHE EMBODIED AI DIRECTORY
Utforska vision-språk-action-modeller och robotbaserade grundmodeller med officiella projektlänkar.
Förvar
Forskning
Koden för "MemoryVLA: Perceptual-Kognitive Memory in Vision-Language-Action Models for Robotic Manipulation"
Vision-språk-handling Förvar
 Forskning
MobileVLA-R1: Förstärkning av syn-språk-handling för mobila robotar
Vision-språk-handling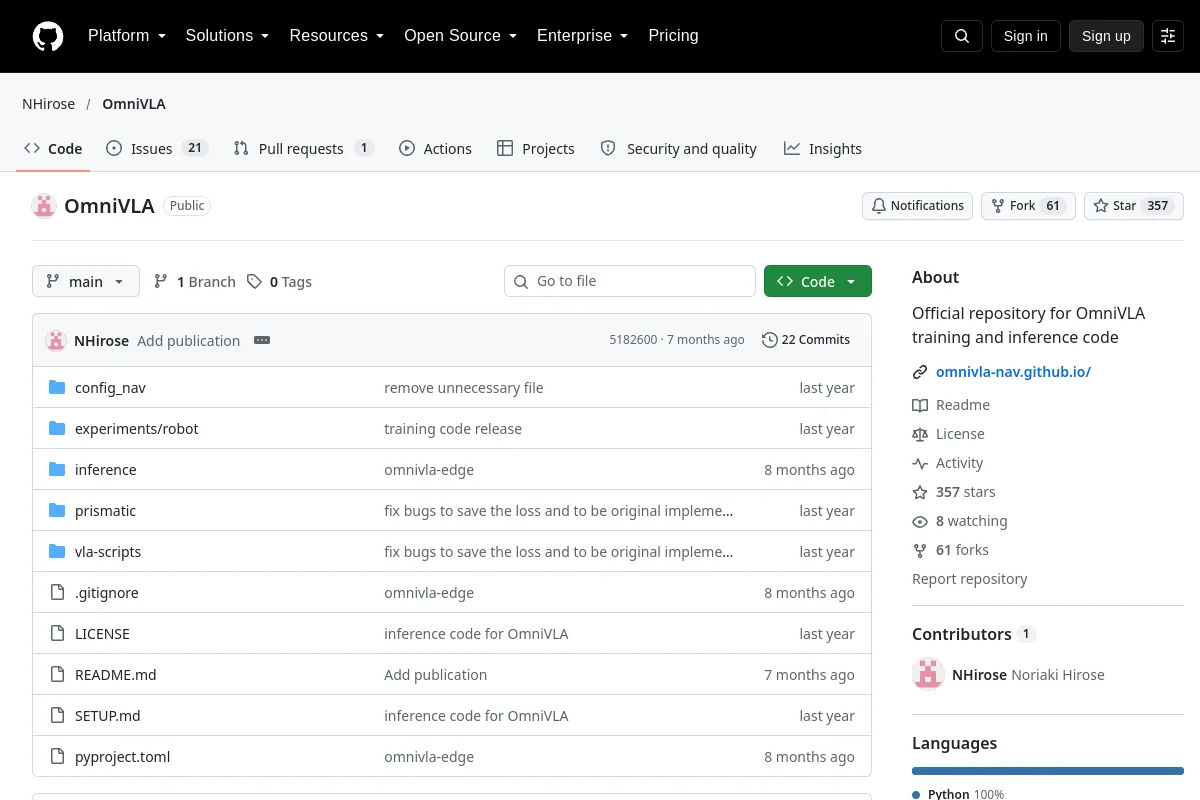 Förvar
 Forskning
OmniVLA tillhandahåller utbildning och slutledningskod för multimodal robotnavigering.
Vision-språk-handling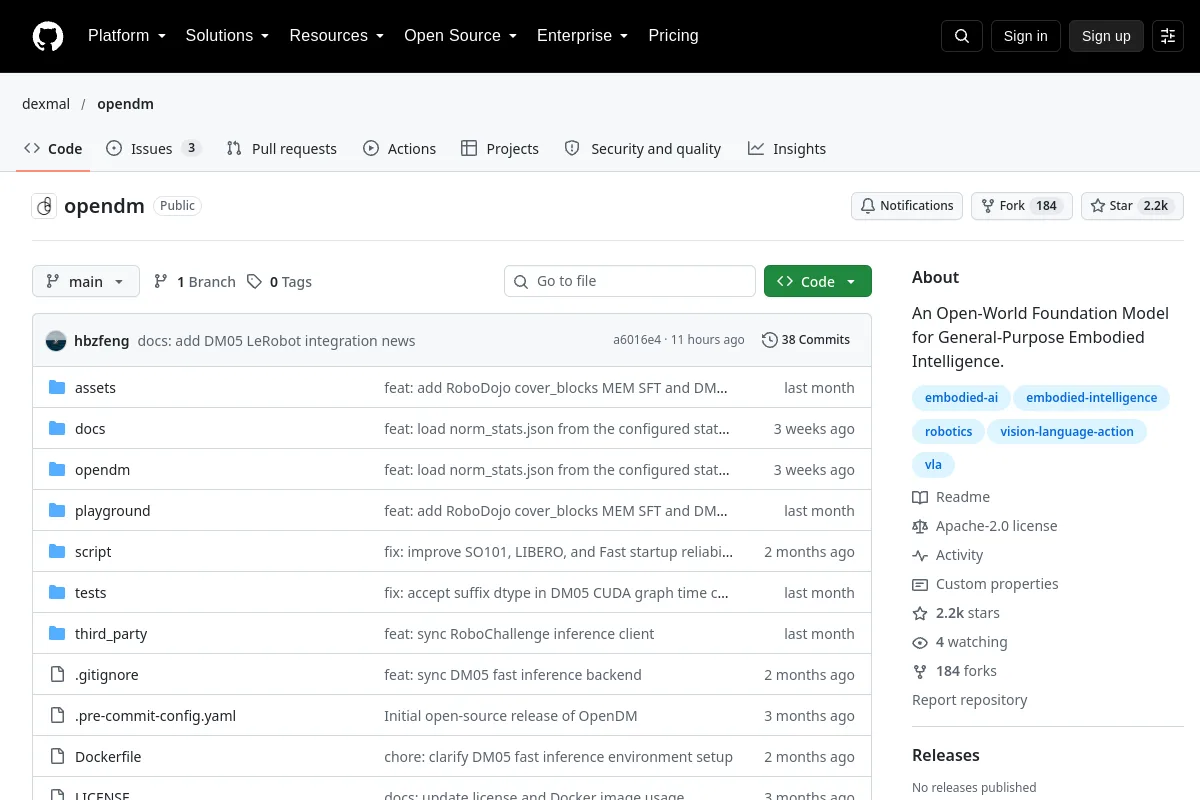 Förvar
 Forskning
OpenDM tillhandahåller ett forskningsprojekt för en öppen värld av grundmodeller för förkroppsligad intelligens.
Vision-språk-handling Förvar
 Forskning
Openpi Dexterous studerar pi0 LoRA-anpassning för Shadow Hand-manipulation och rapporterar experimentella begränsningar.
Vision-språk-handling Förvar
 Forskning
Open Pi Zero är en omimplementering av Physical Intelligences pi0 VLA-modell.
Vision-språk-handling Förvar
 Forskning
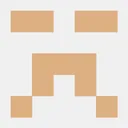
OpenVLA Reproduktion av dokumentinställningar och utvärdering av OpenVLA på LIBERO-uppgifter.
Vision-språk-handling Förvar
 Forskning
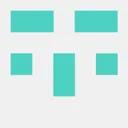
O-VLA studerar VLA-överföring genom semantiskt primitivt lärande.
Vision-språk-handling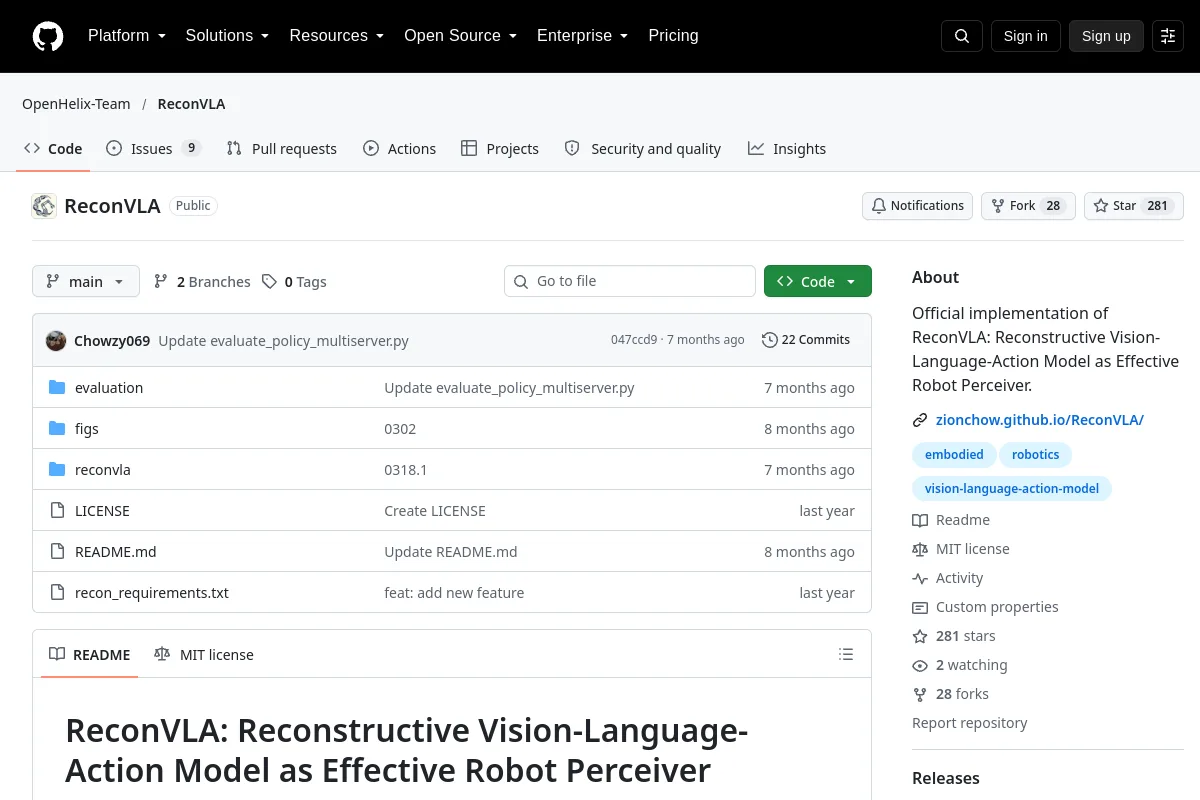 Förvar
 Forskning
Officiell implementering av ReconVLA: Reconstructive Vision-Language-Action Model as Effective Robot Perceiver.
Vision-språk-handling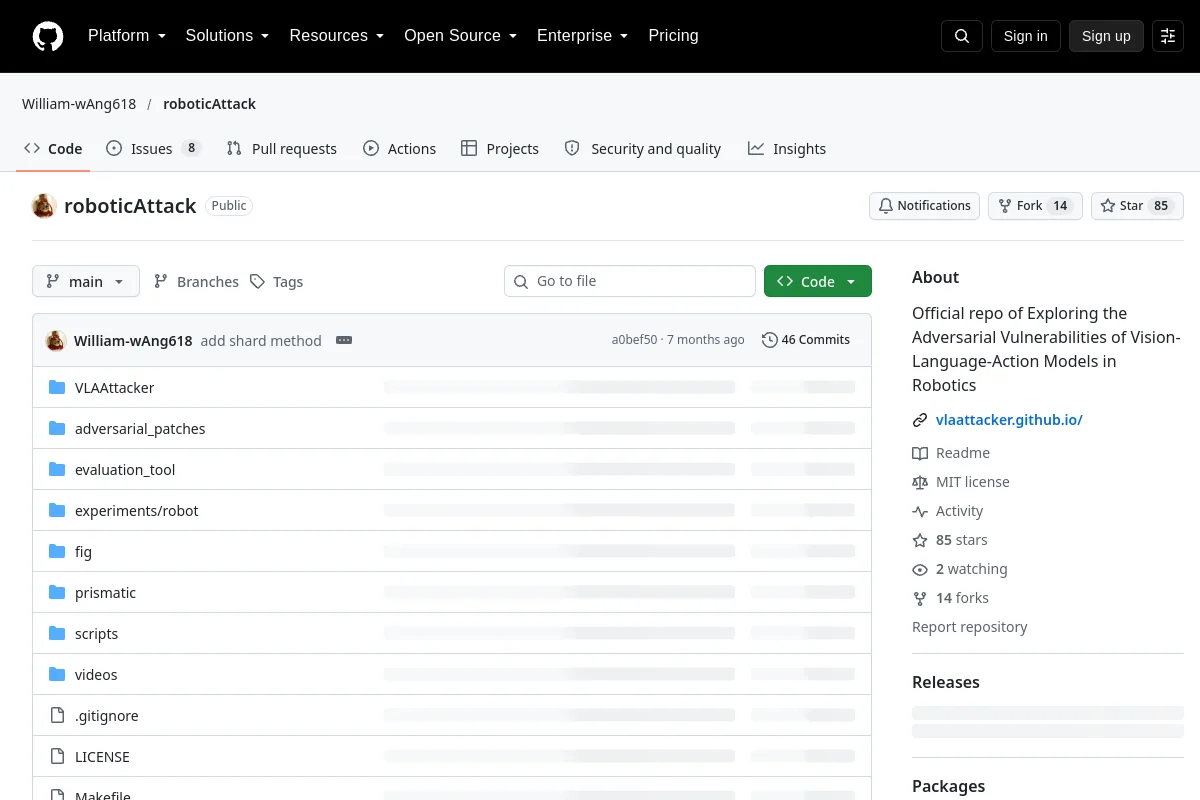 Förvar
 Forskning
Officiell repo av Utforska de kontradiktoriska sårbarheterna hos Vision-Language-Action Models in Robotics
Vision-språk-handling Förvar
 Forskning
Native-videominne för vision-språk-action-modeller, med tidsstämplad visuell historia och exakt streaming-inferens för robotmanipulation med lång horisont.
Vision-språk-handling Förvar
 Forskning
Spirit-v1.5: A Robotic Foundation Model av Spirit AI
Vision-språk-handling Förvar
 Forskning
VIRENA demonstrerar en liten VLA-policy på ManiSkill PickCube med LeRobot integrationsresurser.
Vision-språk-handling Förvar
 Forskning
VITRA: Skalbar Vision-Language-Action Model Pretraining för robotmanipulation med verkliga mänskliga aktivitetsvideor
Vision-språk-handling Förvar
 Forskning
VLA From Scratch jämför aktionsrepresentationer på multimodala demonstrationer och hindersruttningsuppgifter.
Vision-språk-handling Förvar
 Forskning
Mot mångsidiga vision-språk-handlingsmodeller genom att lära sig enhetliga vision-rörelserepresentationer
Vision-språk-handling Webbplats
 Forskning
En vision-språk-action-forskningsmodell för robotmanipulation.
Vision-språk-handling Webbplats
URVALSANMÄRKNINGAR
Kontrollera observationer och åtgärdsrepresentationer som stöds, kontrollpunktslicenser, beräkningskrav och anpassningsdatauppsättningar. Modellvikter ger inte en färdig kontrollenhet för varje robot. Planutvärdering i simulering och kontrollerade hårdvaratester.
Vet du en resurs som hör hemma här?
