 Repozytorium
 Badania
FOCA · cair-vinuni
FOCA bada warunkowanie zorientowane na przyszłość w celu wydajnej adaptacji VLA do danych.
Wizja-język-działanieKATALOG WCIELONEJ AI
Przeglądaj zasoby VLA i robotycznych modeli podstawowych łączących percepcję, instrukcje i działania.
Repozytorium
Badania
FOCA bada warunkowanie zorientowane na przyszłość w celu wydajnej adaptacji VLA do danych.
Wizja-język-działanie Repozytorium
 Badania
Uni-NaVid: oparty na wideo model wizja-język-działanie do ujednolicania ucieleśnionych zadań nawigacji.
Wizja-język-działanie Repozytorium
 Badania
Od modeli wizji, języka i działania po stos uczenia się robotów w świecie rzeczywistym
Wizja-język-działanie Repozytorium
 Badania
VLA-0 zapewnia kod badawczy do budowania modeli wizja-język-działanie na podstawie modeli wizja-język.
Wizja-język-działanie Repozytorium
 Badania
Green-VLA: etapowy model widzenia, języka i działania dla robotów ogólnych
Wizja-język-działanie Repozytorium
 Badania
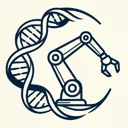
VLA-RFT zapewnia zasoby dostrajające wzmocnienie dla modeli wizja-język-działanie.
Wizja-język-działanie Repozytorium
 Badania
WholebodyVLA bada ukryte reprezentacje VLA dotyczące lokomocji i manipulacji całym ciałem.
Wizja-język-działanie Repozytorium
 Badania
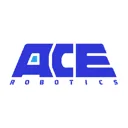
Oficjalne repozytorium pierwszej wersji modelu podstawowego ACE-Brain.
Wizja-język-działanie Repozytorium
 Badania
Anchor-Align bada dostrajanie VLA z zakotwiczeniem reprezentacji i dopasowaniem języka do działania.
Wizja-język-działanie Repozytorium
 Badania
BitVLA implementuje 1-bitowe modele wizja-język-działanie do manipulacji robotycznej.
Wizja-język-działanie Repozytorium
 Badania
CATok bada tokenizację działań przyczynowych dla polityk robotów z warunkowym wyżarzaniem w dopasowywaniu przepływu.
Wizja-język-działanie Repozytorium
 Badania
CLP-VLA zapewnia ukierunkowany na warstwy kod dostrajający i ewaluacyjny dla modeli VLA.
Wizja-język-działanie Repozytorium
 Badania
DEAS Isaac GR00T zapewnia zasoby konfiguracyjne łączące DEAS, Isaac GR00T i RoboCasa.
Wizja-język-działanie Repozytorium
 Badania
Dexora zapewnia zasoby polityki VLA w zakresie zręczności dwuręcznej o wysokim stopniu swobody.
Wizja-język-działanie Repozytorium
 Badania
DynamicVLA zapewnia zasoby badawcze do manipulacji robotami dynamicznymi.
Wizja-język-działanie Repozytorium
 Badania
Projekt EAI2025 łączy w sobie mapowanie semantyczne 3D i wdrażanie VLA w celu manipulacji.
Wizja-język-działanie Repozytorium
 Badania
Emma-X: ucieleśniony multimodalny model działania z ugruntowanym łańcuchem myślenia i rozumowaniem przestrzennym wybiegającym w przyszłość
Wizja-język-działanie Repozytorium
 Badania
FLUX 3 Action zapewnia zasoby do modelowania i przewidywania działań na świecie dla robotów i symulatorów.
Wizja-język-działanie Strona internetowa
 Badania
Modele robotyki Google DeepMind łączące percepcję i działanie.
Wizja-język-działanie Repozytorium
 Badania
HEX to framework obsługujący wizję, język i działanie całego ciała dla pełnowymiarowych robotów humanoidalnych.
Wizja-język-działanie Repozytorium
 Badania
Seria InternVLA-A bada zrozumienie, generowanie i działanie manipulacji robotycznej.
Wizja-język-działanie Repozytorium
 Badania
JanusVLN bada nawigację wizualno-językową z oddzielną pamięcią semantyczną i przestrzenną.
Wizja-język-działanie Repozytorium
 Badania
Kod artykułu „KERV: Kinematic-Rectified Spekulative Decoding for Embodied VLA Models” zaakceptowany przez DAC 2026.
Wizja-język-działanie Repozytorium
 Badania
OSTATNIE$_0$: Ukryty przestrzenno-czasowy łańcuch myślowy dla robotycznego modelu wizja-język-działanie
Wizja-język-działanieUWAGI DO WYBORU
Porównaj dane wejściowe z obserwacji, reprezentacje działań, obsługiwane przykłady wykonania i wymagania adaptacyjne. Przeglądaj licencje na wagę modelu oddzielnie od licencji na kod i roszczeń dotyczących testów porównawczych.
Znasz zasób, który tu pasuje?