 Strona internetowa
 Badania
openpi
Zasoby kodu i modelu dotyczące zasad robotów inteligencji fizycznej.
Wizja-język-działanieKATALOG WCIELONEJ AI
Przeglądaj zasoby VLA i robotycznych modeli podstawowych łączących percepcję, instrukcje i działania.
Strona internetowa
Badania
Zasoby kodu i modelu dotyczące zasad robotów inteligencji fizycznej.
Wizja-język-działanie Repozytorium
 Badania
Zasoby dotyczące modeli podstawowych robotów na potrzeby procesów uczenia się humanoidów.
Wizja-język-działanie Repozytorium
 Badania
NVIDIA Alpamayo 1.5 Nano to otwarty model wnioskowania 10B VLA dla pojazdów autonomicznych z ulepszonym rozumowaniem opartym na uczeniu się przez wzmacnianie, wskazówkami nawigacyjnymi i wizualnym odpowiadaniem na pytania.
Wizja-język-działanie Repozytorium
 Badania
DeeR-VLA bada dynamiczne wnioskowanie z modelu multimodalnego na potrzeby wykonania robota.
Wizja-język-działanie Strona internetowa
 Badania
Narzędzia do precyzyjnego dostrajania w celu dostosowania przewidywania działań OpenVLA.
Wizja-język-działanie Repozytorium
 Badania
InternVLA-M1 zapewnia przestrzennie ukierunkowaną strukturę wizji, języka i działania dla polityk dotyczących robotów.
Wizja-język-działanie Repozytorium
 Badania
Oficjalna wersja kodu i punktu kontrolnego dla podstawowych modeli robotów mobilnych: GNM, ViNT i NoMaD.
Wizja-język-działanie Repozytorium
 Badania
To repozytorium jest implementacją „NaVILA: Legged Robot Vision-Language-Action Model for nawigacji”
Wizja-język-działanie Strona internetowa
 Badania
Struktura łączenia modeli wizjonersko-językowych z działaniami robotycznymi.
Wizja-język-działanie Repozytorium
 Badania
 polityki robotów z wykorzystaniem ukrytych reprezentacji działań.
Wizja-język-działanie Repozytorium
 Badania
InternNav zapewnia platformę do opracowywania podstawowych modeli nawigacji.
Wizja-język-działanie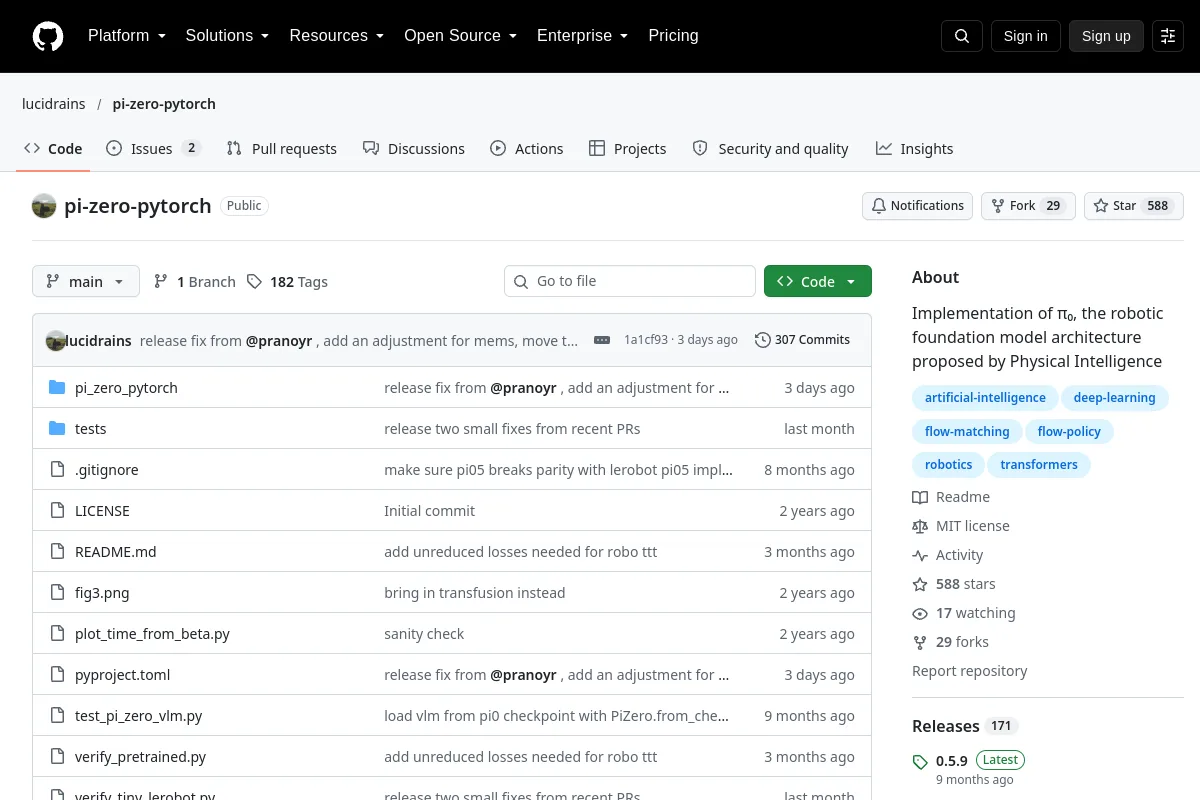 Repozytorium
 Badania
Implementacja π₀, architektury modelu fundamentu robota zaproponowanej przez inteligencję fizyczną
Wizja-język-działanie Repozytorium
 Badania
GraspVLA zapewnia badania modeli chwytania, wstępnie przetrenowane na podstawie syntetycznych danych dotyczących działań.
Wizja-język-działanie Repozytorium
 Badania
🔥 SpatialVLA: ulepszony przestrzennie model widzenia, języka i działania, który został wytrenowany na 1,1 miliona odcinków rzeczywistych robotów. Zaakceptowano na RSS 2025.
Wizja-język-działanie Repozytorium
 Badania
oficjalna implementacja naszego artykułu Steering Your Generalists: Improving Robotic Foundation Models via Value Guidance (CoRL 2024)
Wizja-język-działanie Repozytorium
 Badania
Oficjalny kod MoLe-VLA: dynamiczny model działania języka wizyjnego z pomijaniem warstw poprzez mieszankę warstw w celu wydajnej manipulacji robotem
Wizja-język-działanie Repozytorium
 Badania
BAAI UniVLA zapewnia ujednolicony projekt badawczy dotyczący modelu wizji, języka i działania.
Wizja-język-działanie Repozytorium
 Badania
UniAct bada uniwersalne reprezentacje działań dla ucieleśnionych modeli podstawowych.
Wizja-język-działanie Repozytorium
 Badania
X-VLA bada transformatory wspomagane programowo pod kątem uczenia się poprzez widzenie, język i działanie w różnych postaciach.
Wizja-język-działanie Repozytorium
 Badania
HiMoE-VLA bada hierarchiczną politykę łączenia ekspertów w zakresie uczenia się poprzez wizję, język i działanie.
Wizja-język-działanie Repozytorium
 Badania
SimpleVLA-RL zapewnia zasoby szkoleniowe w zakresie uczenia się przez wzmacnianie w zakresie zasad VLA.
Wizja-język-działanie Repozytorium
 Badania
VLAC: Model oparty na wizji, języku i działaniu dla robotycznego uczenia się ze wzmocnieniem w świecie rzeczywistym
Wizja-język-działanie Repozytorium
 Badania
VLA-RL zapewnia kod uczenia się przez wzmacnianie do dostosowywania modeli VLA do manipulacji robotycznych.
Wizja-język-działanie Repozytorium
 Badania
LingBot-VLA zapewnia projekt oparty na modelu wizji, języka, działania.
Wizja-język-działanieUWAGI DO WYBORU
Porównaj dane wejściowe z obserwacji, reprezentacje działań, obsługiwane przykłady wykonania i wymagania adaptacyjne. Przeglądaj licencje na wagę modelu oddzielnie od licencji na kod i roszczeń dotyczących testów porównawczych.
Znasz zasób, który tu pasuje?