 Website
 Forschung
openpi
Code- und Modellressourcen für Roboterrichtlinien für physische Intelligenz.
Vision-Sprache-AktionDAS VERKÖRPERTE KI-VERZEICHNIS
Entdecken Sie Vision-Sprach-Aktionsmodelle und Robotik-Grundlagenmodelle mit offiziellen Projektlinks.
Website
Forschung
Code- und Modellressourcen für Roboterrichtlinien für physische Intelligenz.
Vision-Sprache-Aktion Repository
 Forschung
Ressourcen für Roboterfundamentmodelle für humanoide Lernabläufe.
Vision-Sprache-Aktion Repository
 Forschung
NVIDIA Alpamayo 1.5 Nano ist ein offenes 10B-Begründungs-VLA-Modell für autonome Fahrzeuge mit durch Verstärkungslernen verbessertem Denken, Navigationsführung und visueller Fragebeantwortung.
Vision-Sprache-Aktion Repository
 Forschung
DeeR-VLA untersucht dynamische multimodale Modellinferenz für die Roboterausführung.
Vision-Sprache-Aktion Website
 Forschung
Feinabstimmungstools zur Anpassung der OpenVLA-Aktionsvorhersage.
Vision-Sprache-Aktion Repository
 Forschung
InternVLA-M1 bietet ein räumlich geführtes Vision-Sprach-Aktions-Framework für Roboterrichtlinien.
Vision-Sprache-Aktion Repository
 Forschung
Offizielle Code- und Checkpoint-Veröffentlichung für mobile Roboterfundamentmodelle: GNM, ViNT und NoMaD.
Vision-Sprache-Aktion Repository
 Forschung
Dieses Repository ist die Implementierung von „NaVILA: Legged Robot Vision-Language-Action Model for Navigation“
Vision-Sprache-Aktion Website
 Forschung
Ein Framework zur Verbindung von Vision-Sprachmodellen mit Roboteraktionen.
Vision-Sprache-Aktion Repository
 Forschung
Roboterpolitikforschung unter Verwendung latenter Handlungsdarstellungen.
Vision-Sprache-Aktion Repository
 Forschung
InternNav bietet eine Plattform für die Entwicklung von Navigationsgrundmodellen.
Vision-Sprache-Aktion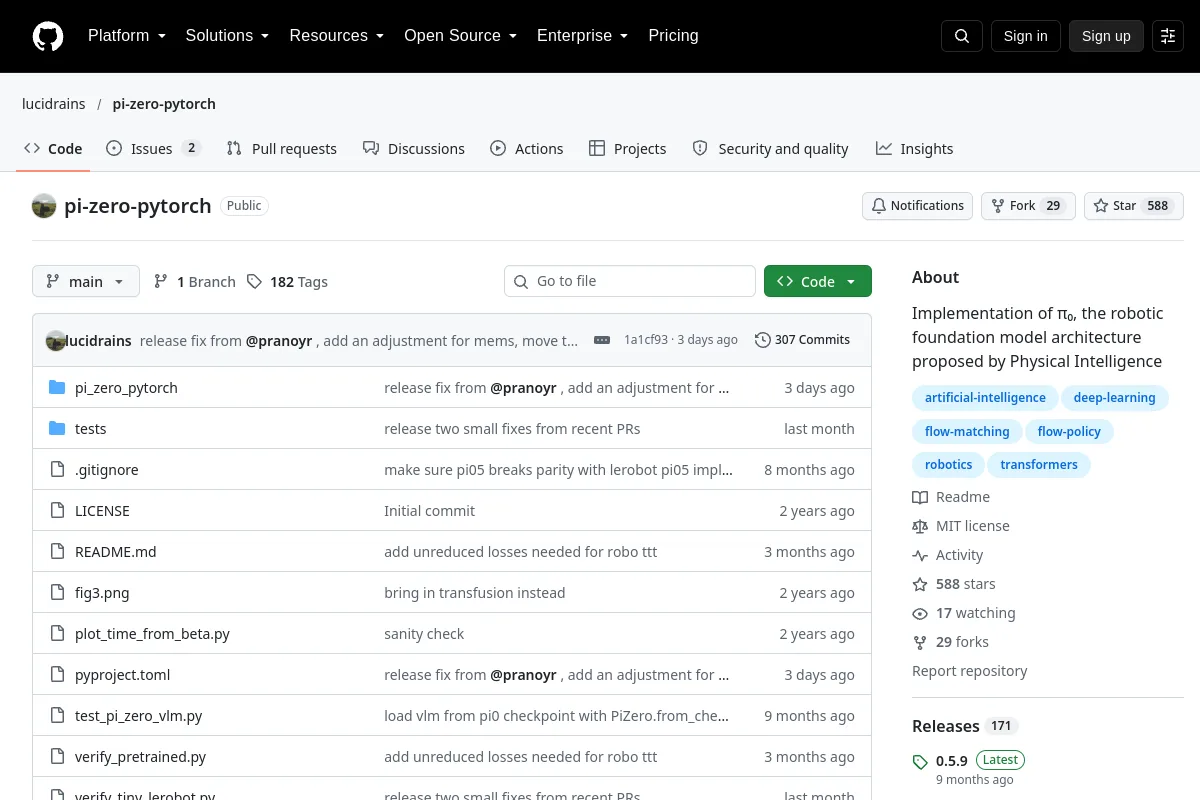 Repository
 Forschung
Implementierung von π₀, der von Physical Intelligence vorgeschlagenen Roboter-Grundmodellarchitektur
Vision-Sprache-Aktion Repository
 Forschung
GraspVLA bietet Greifmodellforschung, die mit synthetischen Aktionsdaten vorab trainiert wurde.
Vision-Sprache-Aktion Repository
 Forschung
🔥 SpatialVLA: ein räumlich verbessertes Vision-Sprach-Aktionsmodell, das auf 1,1 Millionen echten Roboterepisoden trainiert wurde. Akzeptiert bei RSS 2025.
Vision-Sprache-Aktion Repository
 Forschung
offizielle Umsetzung für unser Paper Steering Your Generalists: Improving Robotic Foundation Models via Value Guidance (CoRL 2024)
Vision-Sprache-Aktion Repository
 Forschung
Offizieller Code für MoLe-VLA: Dynamisches Layer-Skipping-Vision-Language-Action-Modell über Layer-Mixture-of-Layers für eine effiziente Robotermanipulation
Vision-Sprache-Aktion Repository
 Forschung
BAAI UniVLA bietet ein einheitliches Forschungsprojekt für Vision-Sprach-Aktionsmodelle.
Vision-Sprache-Aktion Repository
 Forschung
UniAct untersucht universelle Aktionsdarstellungen für verkörperte Fundamentmodelle.
Vision-Sprache-Aktion Repository
 Forschung
X-VLA untersucht Soft-Prompted-Transformatoren für das verkörperungsübergreifende Lernen von Vision, Sprache und Aktion.
Vision-Sprache-Aktion Repository
 Forschung
HiMoE-VLA untersucht hierarchische Expertenmischungsrichtlinien für Vision-Sprache-Aktion-Lernen.
Vision-Sprache-Aktion Repository
 Forschung
SimpleVLA-RL bietet Schulungsressourcen zur Verstärkung des Lernens für VLA-Richtlinien.
Vision-Sprache-Aktion Repository
 Forschung
VLAC: Ein visionäres, handlungskritisches Modell für robotergestütztes Verstärkungslernen in der realen Welt
Vision-Sprache-Aktion Repository
 Forschung
VLA-RL bietet Reinforcement-Learning-Code zur Anpassung von VLA-Modellen an die Robotermanipulation.
Vision-Sprache-Aktion Repository
 Forschung
LingBot-VLA bietet ein Vision-Sprache-Aktion-Grundmodellprojekt.
Vision-Sprache-AktionAUSWAHLHINWEISE
Überprüfen Sie unterstützte Beobachtungen und Aktionsdarstellungen, Checkpoint-Lizenzen, Rechenanforderungen und Anpassungsdatensätze. Modellgewichte bieten nicht für jeden Roboter eine fertige Steuerung. Planbewertung in Simulation und kontrollierten Hardwaretests.
Kennen Sie eine Ressource, die hierher gehört?