 Webbplats
 Forskning
Cosmos Policy
Ett robotpolitiskt projekt som använder världsmodellrepresentationer.
Världens modellerTHE EMBODIED AI DIRECTORY
Utforska vision-språk-action-modeller och robotmodeller för perception, manipulation och kontroll.
Webbplats
Forskning
Ett robotpolitiskt projekt som använder världsmodellrepresentationer.
Världens modeller Förvar
 Forskning
Uni-NaVid: En videobaserad Vision-Language-Action Model för att förena förkroppsligade navigeringsuppgifter.
Vision-språk-handling Förvar
 Forskning
världsmodelleringsutmaning för humanoida robotar
Världens modeller Förvar
 Förvar
 Forskning
Being-H är BeingBeyonds familj av människocentrerade grundmodeller.
Robotpolitik Förvar
 Forskning
Från vision-språk-handlingsmodeller till en verklig robotinlärningsstapel
Vision-språk-handling Förvar
 Forskning
VLA-0 tillhandahåller forskningskod för att bygga vision-språk-action-modeller från vision-språk-modeller.
Vision-språk-handling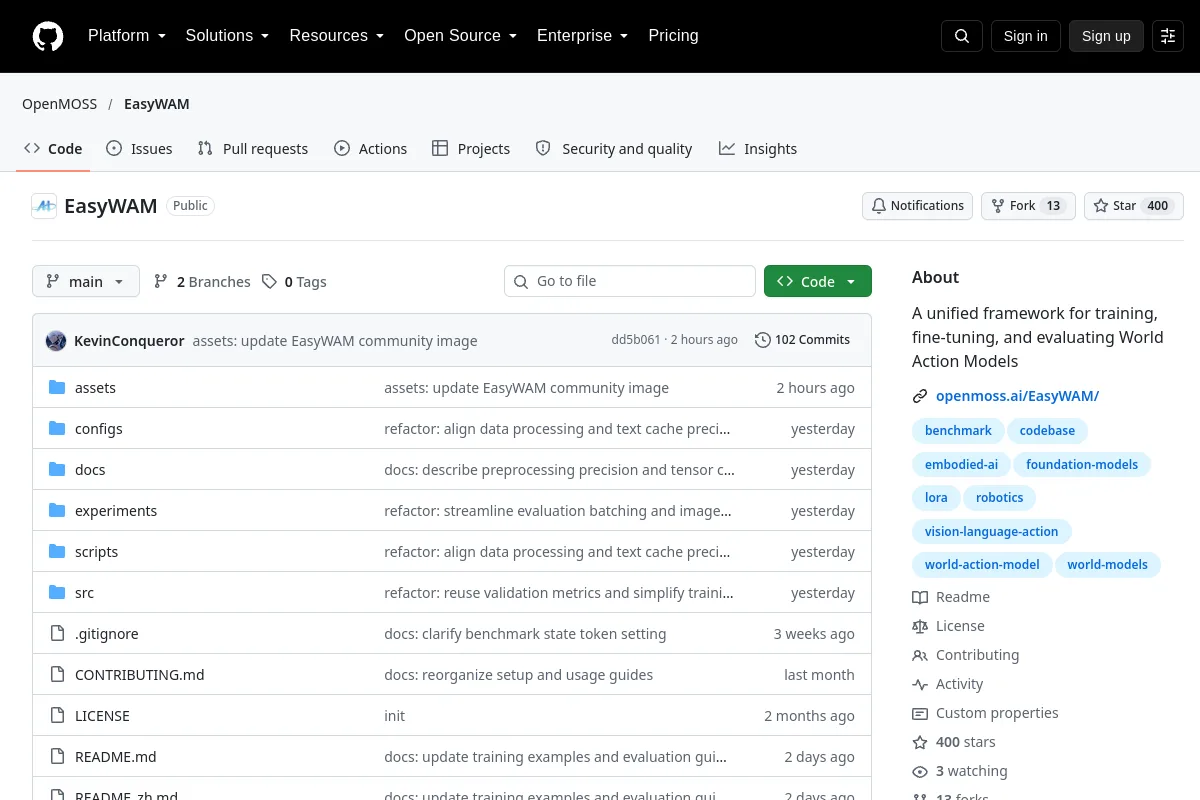 Förvar
 Forskning
Ett enhetligt ramverk för utbildning, finjustering och utvärdering av World Action Models
Världens modeller Förvar
 Forskning
ICCV 2025 | TesserAct: Learning 4D Embodied World Models
Världens modeller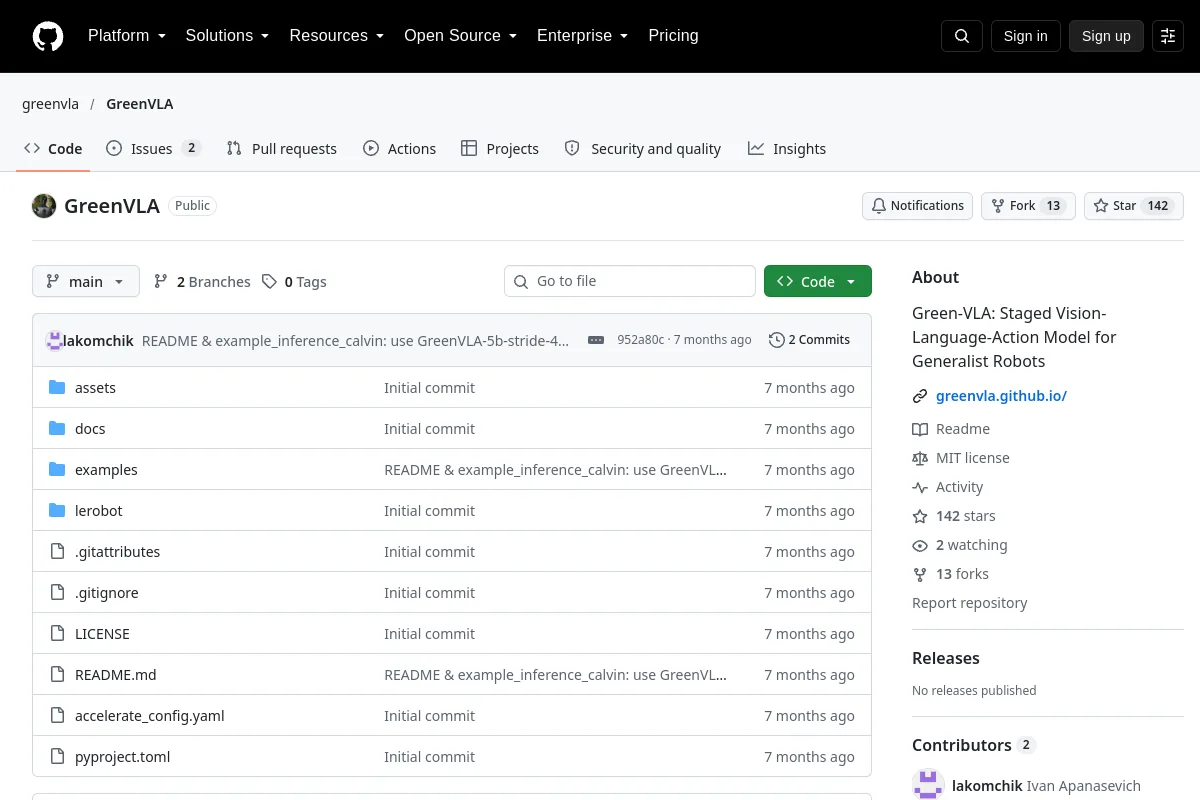 Förvar
 Forskning
Green-VLA: iscensatt vision-språk-handlingsmodell för generalistrobotar
Vision-språk-handling Förvar
 Forskning
Kod för RISE: Self-Improving Robot Policy with Compositional World Model
Världens modeller Förvar
 Forskning
VLA-RFT tillhandahåller förstärkande finjusteringsresurser för vision-språk-action-modeller.
Vision-språk-handling Förvar
 Forskning
En världsmodellförbättrad VLA för styrbar skicklig manipulation, tillsammans med optimerad träningsinfra.
Världens modeller Förvar
 Forskning
En baslinjeimplementering för greppdetektering från punktmolndata.
Gripande modeller Förvar
 Forskning
Lättviktsimplementering av Robotic World Model (RWM) och Uncertainty-Aware Robotic World Model (RWM-U)
Världens modeller Förvar
 Forskning
WholebodyVLA studerar latenta VLA-representationer för rörelse och manipulation av hela kroppen.
Vision-språk-handling Förvar
 Forskning
3D-CovDiffusion implementerar en 3D-medveten spridningspolicy för planering av täckningsvägar.
Robotpolitik Förvar
 Forskning
Det officiella arkivet för den första versionen av ACE-Brain-grundmodellen.
Vision-språk-handling Förvar
 Forskning
ACOT-VLA-WM är ett avancerat Vision-Language-Action-robotramverk som använder en prediktiv världsmodell för att generera visuella delmål, förbättra robotmanipulationsnoggrannheten på lång horisont och...
Världens modeller Förvar
 Förvar
 Forskning
Officiell kod för "motståndsrörelse och rörelseimitation för humanoid policyinlärning"
Robotpolitik Förvar
 Forskning
Anchor-Align studerar VLA-finjustering med representationsförankring och språkhandlingsanpassning.
Vision-språk-handling Förvar
 Forskning
AnyLoc tillhandahåller forskningskod för visuell platsigenkänning för lokalisering.
Perceptionsmodeller Förvar
Vet du en resurs som hör hemma här?