 Förvar
 Forskning
NVIDIA Isaac GR00T
Robotfundamentmodellresurser för humanoida inlärningsarbetsflöden.
Vision-språk-handling
Forskning & lärande / Forskning
Awesome Embodied VLA VA VLN samlar forskning om förkroppsligade handlingsmodeller och vision-språknavigering.
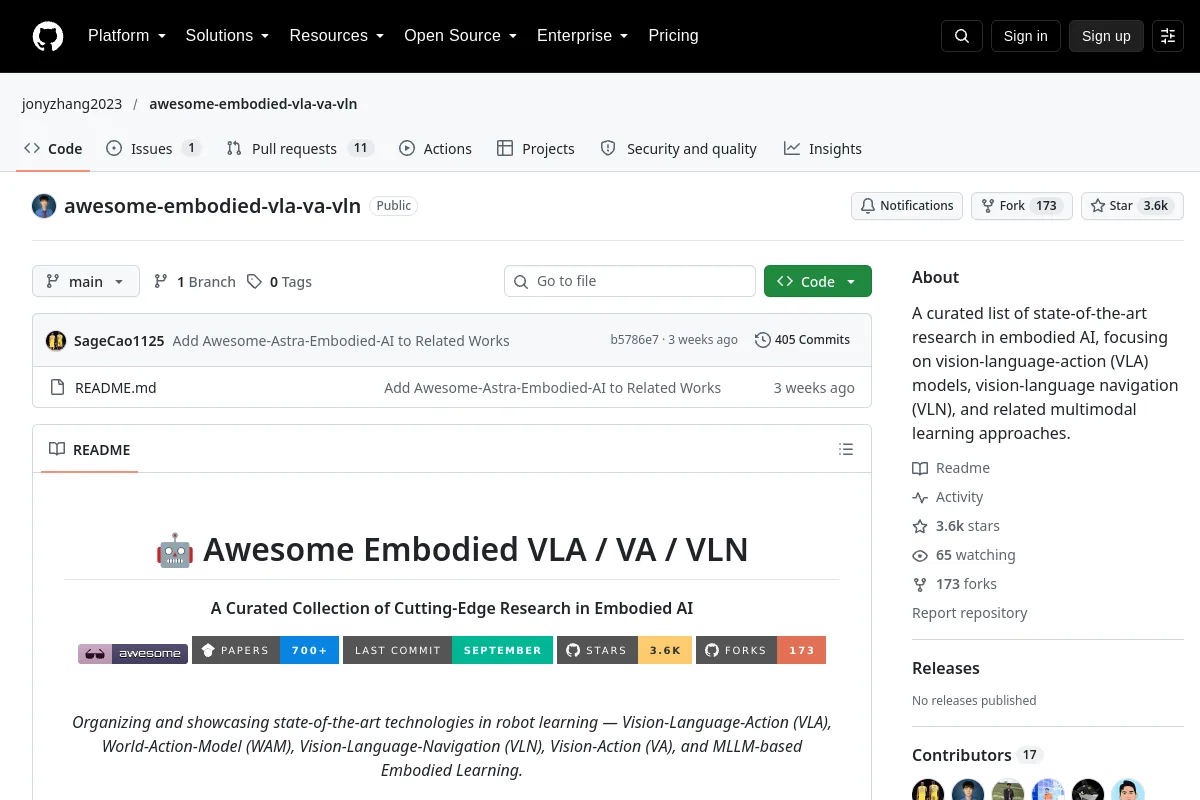
Awesome Embodied VLA VA VLN samlar in forskning om förkroppsligade handlingsmodeller och vision-språknavigering.
Förlagssammanfattning: "En kurerad lista över toppmodern forskning inom förkroppsligad AI, med fokus på vision-language-action (VLA)-modeller, vision-language navigation (VLN) och relaterade multimodala lärandemetoder."
Använd dess arkiv för att inspektera implementeringen, dokumentationen och arbetsflöden som stöds. Denna katalogpost identifierar underhållaren, kodlicensen och relaterade resurser; det gör inte anspråk på att projektet har installerats eller testat på din robot.
Kodlicenser täcker inte automatiskt modellvikter, datauppsättningar eller hårdvarudesigner. Oinspelade licensdetaljer kräver bekräftelse med utgivaren.
Förvar
Forskning
Robotfundamentmodellresurser för humanoida inlärningsarbetsflöden.
Vision-språk-handling Förvar
 Forskning
Dexbotic tillhandahåller en verktygslåda för utveckling av vision-språk-actionmodeller.
Robotinlärningsramar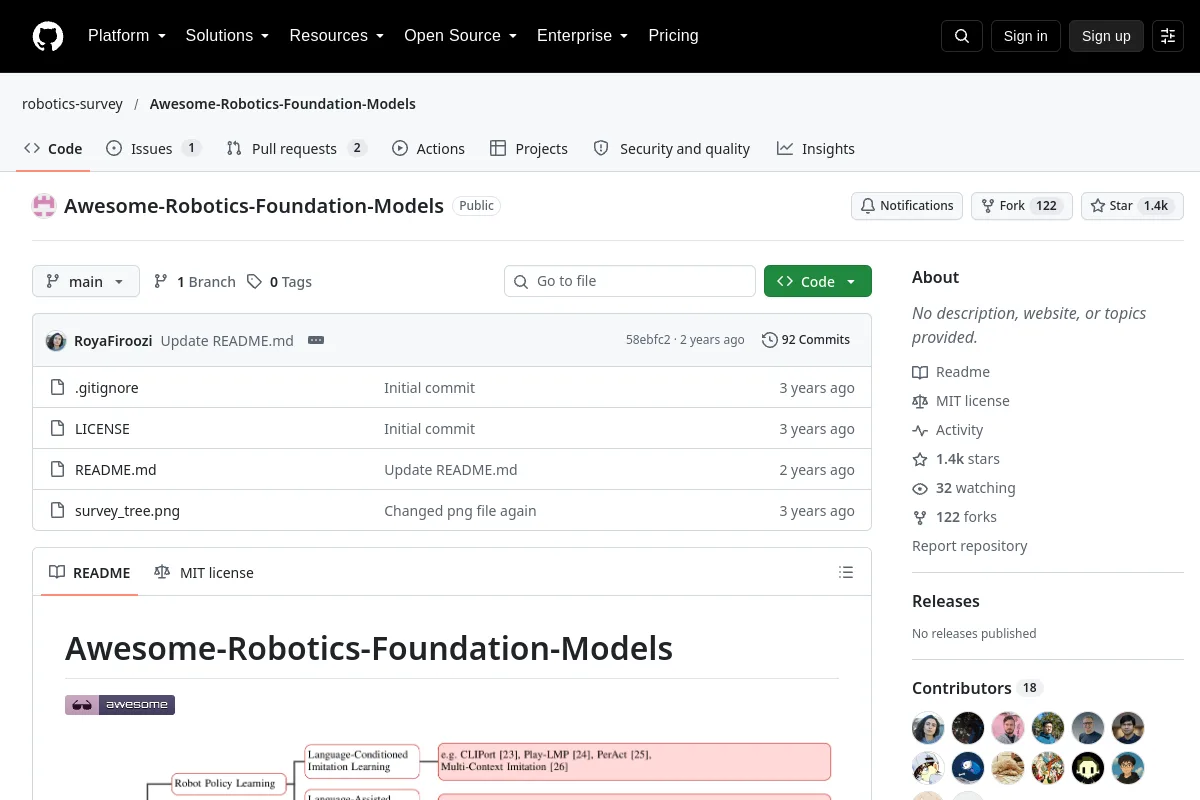 Förvar
 Öppen källkod
Awesome-Robotics-Foundation-Modeller
Standarder & referenssamlingar Förvar
 Forskning
AwesomeWorldModels följer med en undersökning av världsmodeller för förkroppsligad AI.
Standarder & referenssamlingar Förvar
 Forskning
Ett forskningsprojekt för video-actionmodeller för robotstyrning.
Världens modeller Förvar
 Forskning
MF-RV följer med en kartläggning av multimodal fusion för robotseende.
Standarder & referenssamlingar