 Deposito
 Ricerca
NVIDIA Isaac GR00T
Risorse del modello di base dei robot per flussi di lavoro di apprendimento degli umanoidi.
Visione-linguaggio-azione
Ricerca e apprendimento / Ricerca
Awesome Emfilled VLA VA VLN raccoglie ricerche sui modelli di azione incarnata e sulla navigazione del linguaggio visivo.
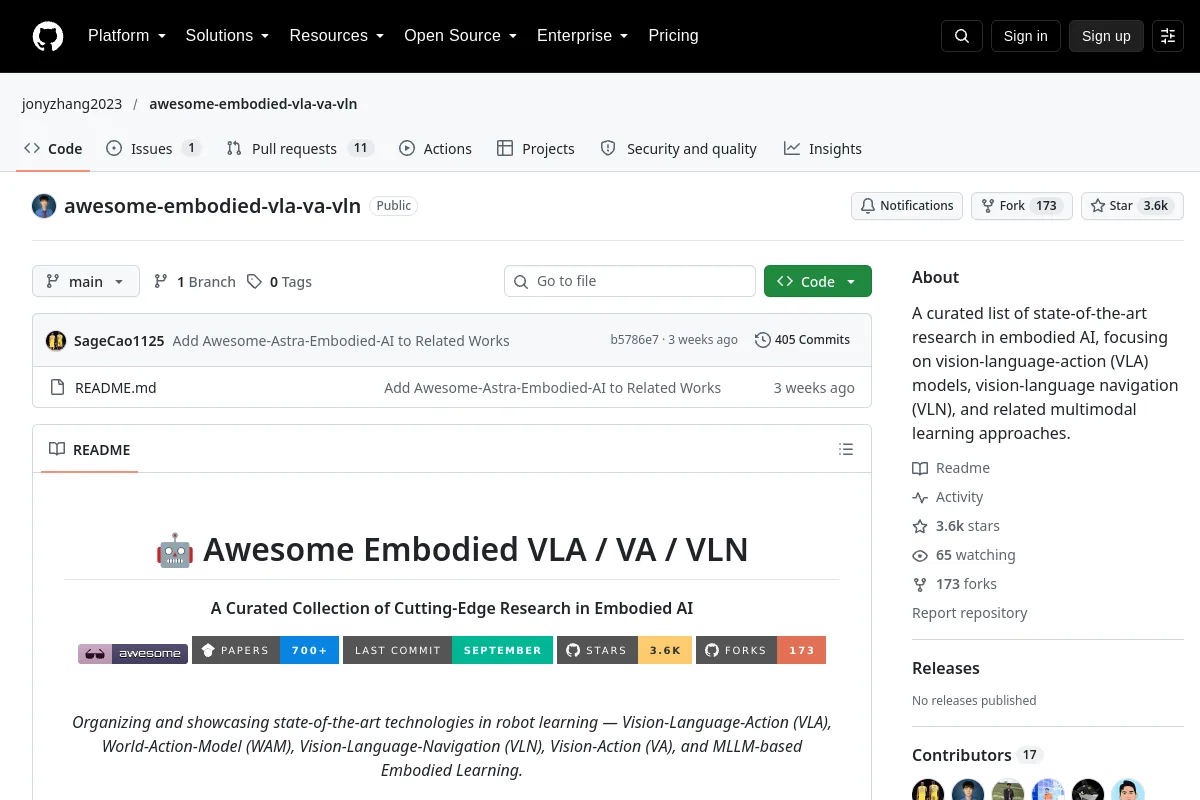
Awesome Emfilled VLA VA VLN raccoglie ricerche sui modelli di azione incarnata e sulla navigazione del linguaggio visivo.
Riepilogo dell'editore: "Un elenco curato di ricerche all'avanguardia nell'intelligenza artificiale incarnata, incentrato su modelli visione-linguaggio-azione (VLA), navigazione visione-linguaggio (VLN) e relativi approcci di apprendimento multimodale."
Utilizza il suo repository per ispezionare l'implementazione, la documentazione e i flussi di lavoro supportati. Questo record della directory identifica il manutentore, la licenza del codice e le risorse correlate; non afferma che il progetto sia stato installato o testato sul tuo robot.
Le licenze del codice non coprono automaticamente i pesi dei modelli, i set di dati o le progettazioni hardware. I dettagli della licenza non registrati richiedono la conferma con l'editore.
Deposito
Ricerca
Risorse del modello di base dei robot per flussi di lavoro di apprendimento degli umanoidi.
Visione-linguaggio-azione Deposito
 Ricerca
Dexbotic fornisce una serie di strumenti per lo sviluppo di modelli di visione-linguaggio-azione.
Strutture di apprendimento dei robot Deposito
 Fonte aperta
Fantastici modelli di basi per la robotica
Standard e raccolte di riferimento Deposito
 Ricerca
AwesomeWorldModels accompagna un sondaggio sui modelli mondiali per l'intelligenza artificiale incarnata.
Standard e raccolte di riferimento Deposito
 Ricerca
Un progetto di ricerca sul modello di azione video per il controllo robotico.
Modelli mondiali Deposito
 Ricerca
MF-RV accompagna un'indagine sulla fusione multimodale per la visione robotica.
Standard e raccolte di riferimento