 Förvar
 Öppen källkod
RLinf
Förstärkningsinlärningsinfrastruktur för förkroppsligade modeller och robotpolicyer.
Robotinlärningsramar
Forskning & lärande / Forskning
Awesome VLA RL organiserar forskning som kombinerar vision-språk-handlingsmodeller och förstärkningsinlärning.
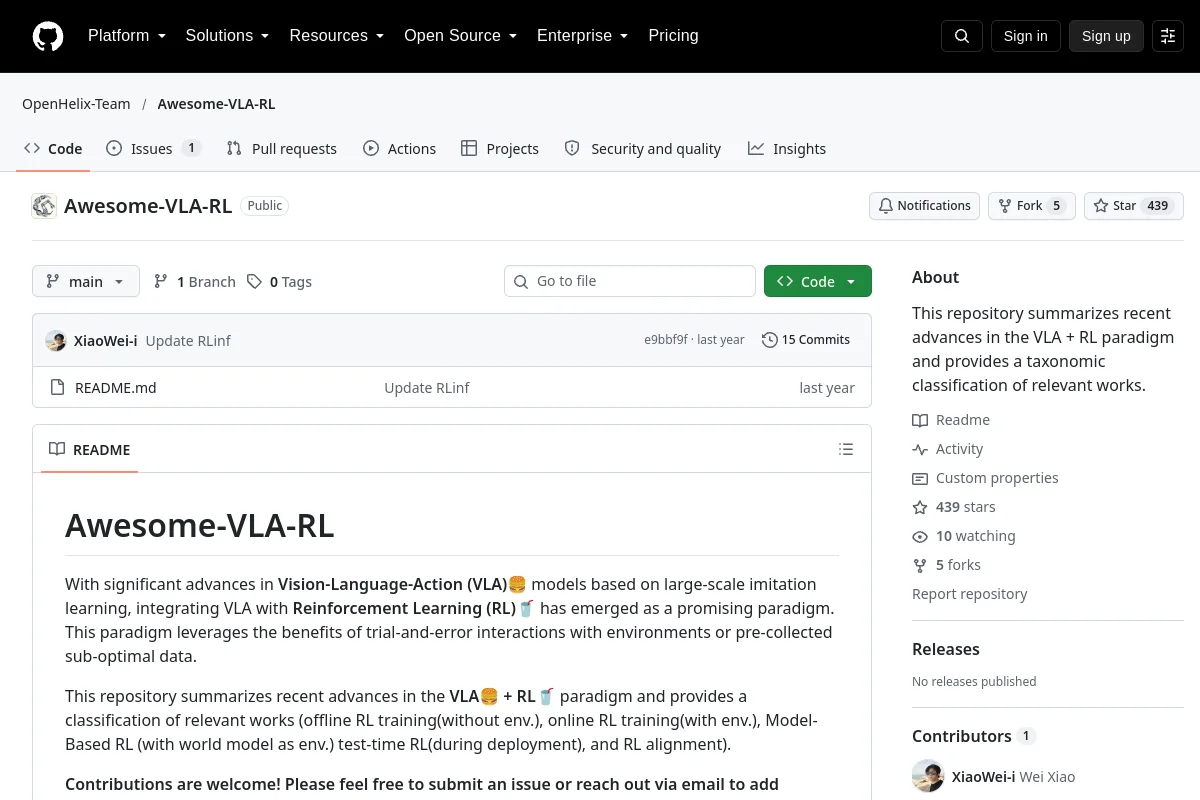
Awesome VLA RL organiserar forskning som kombinerar vision-språk-handlingsmodeller och förstärkningsinlärning.
Förlagssammanfattning: "Detta arkiv sammanfattar de senaste framstegen i VLA + RL-paradigmet och ger en taxonomisk klassificering av relevanta verk."
Använd dess arkiv för att inspektera implementeringen, dokumentationen och arbetsflöden som stöds. Denna katalogpost identifierar underhållaren, kodlicensen och relaterade resurser; det gör inte anspråk på att projektet har installerats eller testat på din robot.
Kodlicenser täcker inte automatiskt modellvikter, datauppsättningar eller hårdvarudesigner. Oinspelade licensdetaljer kräver bekräftelse med utgivaren.
Förvar
Öppen källkod
Förstärkningsinlärningsinfrastruktur för förkroppsligade modeller och robotpolicyer.
Robotinlärningsramar Förvar
 Forskning
officiell implementering av vårt papper Steering Your Generalists: Improving Robotic Foundation Models via Value Guidance (CoRL 2024)
Vision-språk-handling Förvar
 Forskning
SimpleVLA-RL tillhandahåller utbildningsresurser för förstärkning av VLA-policyer.
Vision-språk-handling Förvar
 Forskning
VLAC: En Vision-Language-Action-Critic Model for Robotic Real-World Reinforcement Learning
Vision-språk-handling Förvar
 Forskning
VLA-RL tillhandahåller förstärkningsinlärningskod för anpassning av VLA-modeller till robotmanipulation.
Vision-språk-handling