 Repository
 Open Source
RLinf
Reinforcement-Learning-Infrastruktur für verkörperte Modelle und Roboterrichtlinien.
Frameworks für das Lernen von Robotern
Forschen und Lernen / Forschung
Awesome VLA RL organisiert Forschung, die Vision-Sprach-Aktionsmodelle und verstärkendes Lernen kombiniert.
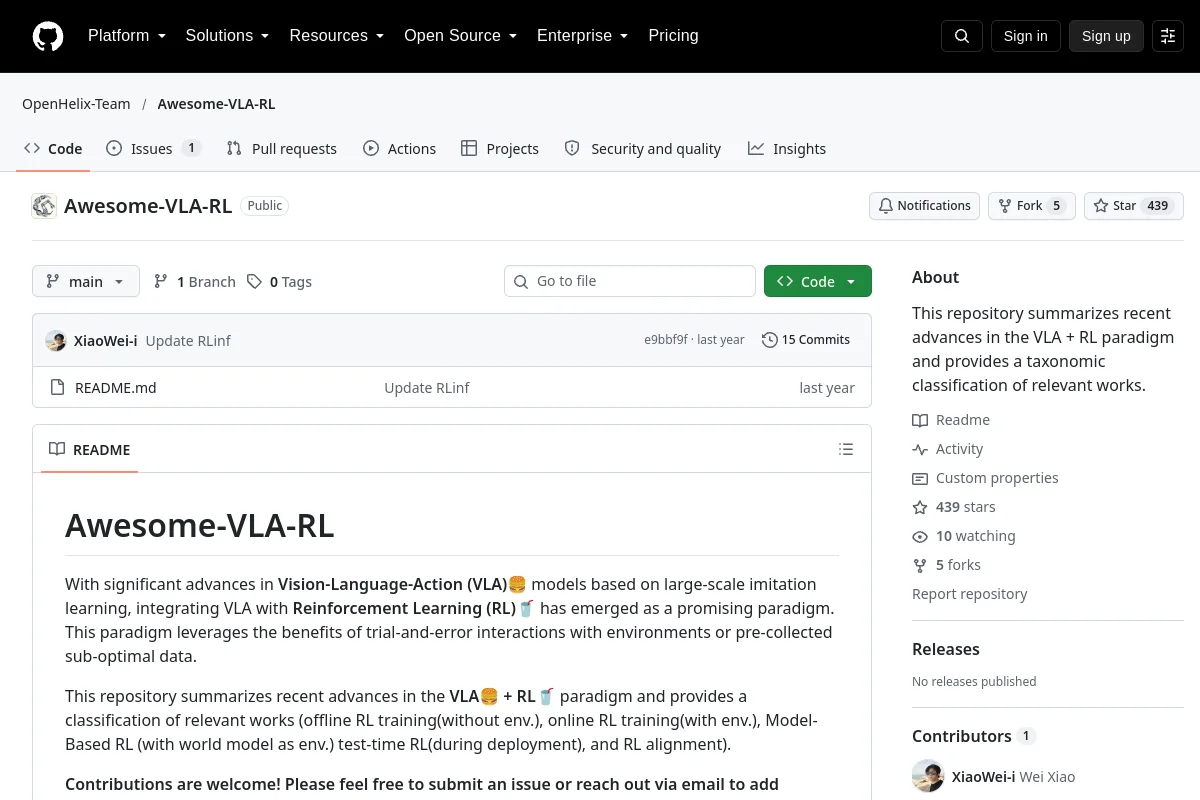
Awesome VLA RL organisiert Forschung, die Vision-Sprach-Aktionsmodelle und verstärkendes Lernen kombiniert.
Zusammenfassung des Herausgebers: „Dieses Repository fasst die jüngsten Fortschritte im VLA + RL-Paradigma zusammen und bietet eine taxonomische Klassifizierung relevanter Werke.“
Verwenden Sie das Repository, um die Implementierung, Dokumentation und unterstützten Arbeitsabläufe zu überprüfen. Dieser Verzeichniseintrag identifiziert den Betreuer, die Codelizenz und zugehörige Ressourcen; Es wird nicht behauptet, dass das Projekt auf Ihrem Roboter installiert oder getestet wurde.
Codelizenzen decken nicht automatisch Modellgewichte, Datensätze oder Hardwaredesigns ab. Nicht erfasste Lizenzdetails bedürfen der Bestätigung durch den Herausgeber.
Repository
Open Source
Reinforcement-Learning-Infrastruktur für verkörperte Modelle und Roboterrichtlinien.
Frameworks für das Lernen von Robotern Repository
 Forschung
offizielle Umsetzung für unser Paper Steering Your Generalists: Improving Robotic Foundation Models via Value Guidance (CoRL 2024)
Vision-Sprache-Aktion Repository
 Forschung
SimpleVLA-RL bietet Schulungsressourcen zur Verstärkung des Lernens für VLA-Richtlinien.
Vision-Sprache-Aktion Repository
 Forschung
VLAC: Ein visionäres, handlungskritisches Modell für robotergestütztes Verstärkungslernen in der realen Welt
Vision-Sprache-Aktion Repository
 Forschung
VLA-RL bietet Reinforcement-Learning-Code zur Anpassung von VLA-Modellen an die Robotermanipulation.
Vision-Sprache-Aktion