 Förvar
 Forskning
Robotics Toolbox for Python
Python-verktyg och exempel för robotikutbildning och algoritmutforskning.
Kurser & dokumentation
Forskning & lärande / Forskning
Awesome VLA4AD samlar in vision-språk-actionforskning för autonom körning och åtföljer en undersökning.
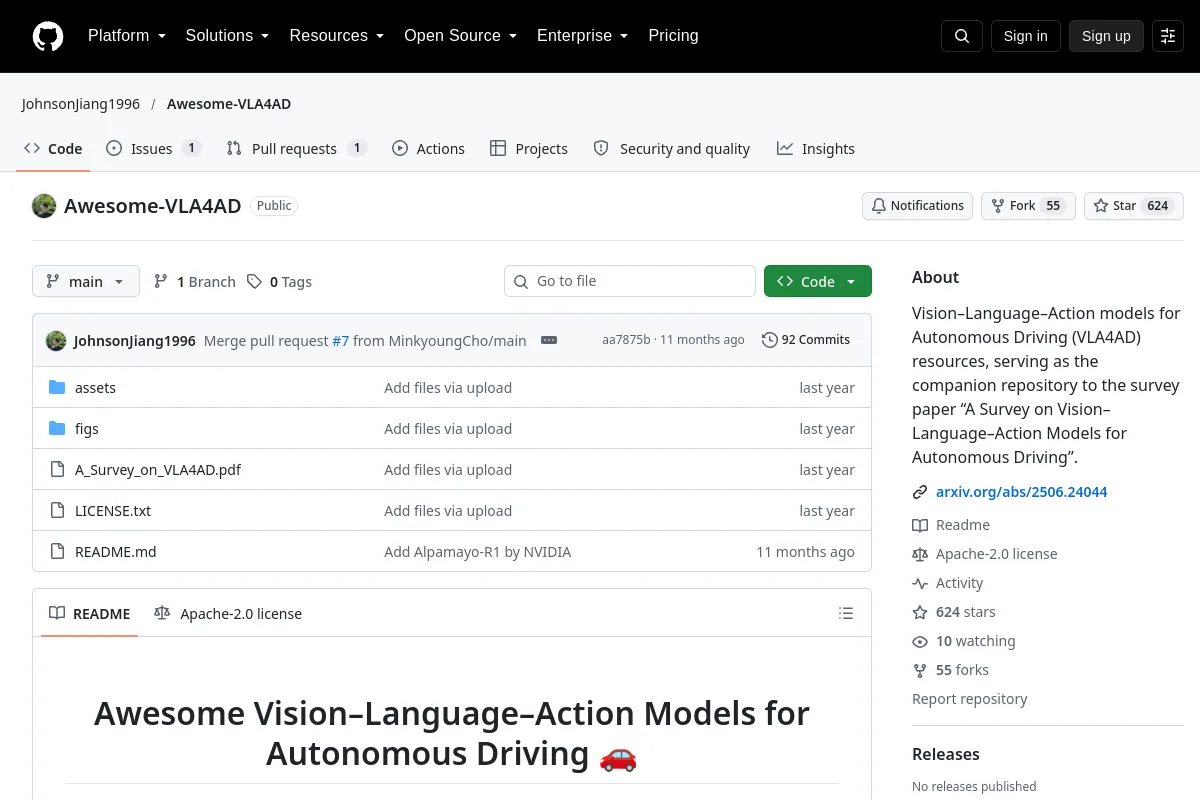
Awesome VLA4AD samlar in vision-språk-actionforskning för autonom körning och åtföljer en undersökning.
Förlagssammanfattning: "Vision–Language–Action models for Autonomous Driving (VLA4AD)-resurser, som fungerar som ett komplement till undersökningsdokumentet "A Survey on Vision–Language– Action Models for Autonomous Driving".
Använd dess arkiv för att inspektera implementeringen, dokumentationen och arbetsflöden som stöds. Denna katalogpost identifierar underhållaren, kodlicensen och relaterade resurser; det gör inte anspråk på att projektet har installerats eller testat på din robot.
Kodlicenser täcker inte automatiskt modellvikter, datauppsättningar eller hårdvarudesigner. Oinspelade licensdetaljer kräver bekräftelse med utgivaren.
Förvar
Forskning
Python-verktyg och exempel för robotikutbildning och algoritmutforskning.
Kurser & dokumentation Förvar
 Öppen källkod
En handledning om manipulatorns differentiell kinematik
Kurser & dokumentation Förvar
 Förvar
 Öppen källkod
Den engelska versionen av 14 föreläsningar om visuell SLAM.
Kurser & dokumentation Förvar
 Forskning
zenoh-plugin-ros2dds tillhandahåller en Zenoh-plugin och brygga för ROS 2-kommunikation över DDS.
Standarder & referenssamlingar Förvar
 Forskning
Embodied AI Lab är ett forskningsnav som täcker VLA, datainfrastruktur och robotikutvärdering.
Standarder & referenssamlingar