45 次里成功 25 次,换到真机只剩 11 次。这是 SO-101 Bench 预印本中 GR00T N1.7 的结果。更有意思的是,五套系统到了真机,名次一位没变。仿真在这组实验中把候选排对了,却不能直接拿来估算上线成功率。
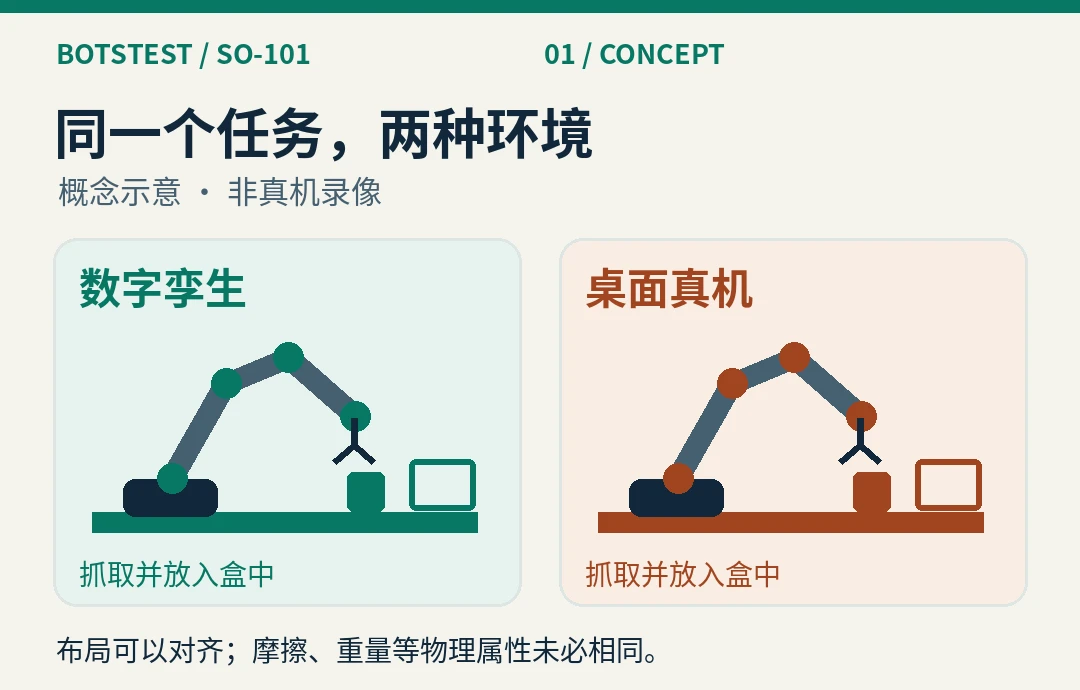
机械臂与工位为原创示意。数值来自作者预印本。
名次一样,分数不一样
| 系统 | 仿真成功 | 真机成功 | 差距(百分点) |
|---|---|---|---|
| GPT-6.1 Sol + PyRUA + Galaxea 0.5 | 38/45 | 29/45 | 20.0 |
| Galaxea 0.5 | 30/45 | 24/45 | 13.3 |
| GR00T N1.7 | 25/45 | 11/45 | 31.1 |
| π0.5 | 22/45 | 8/45 | 31.1 |
| MolmoAct2-SO101 | 11/45 | 7/45 | 8.9 |
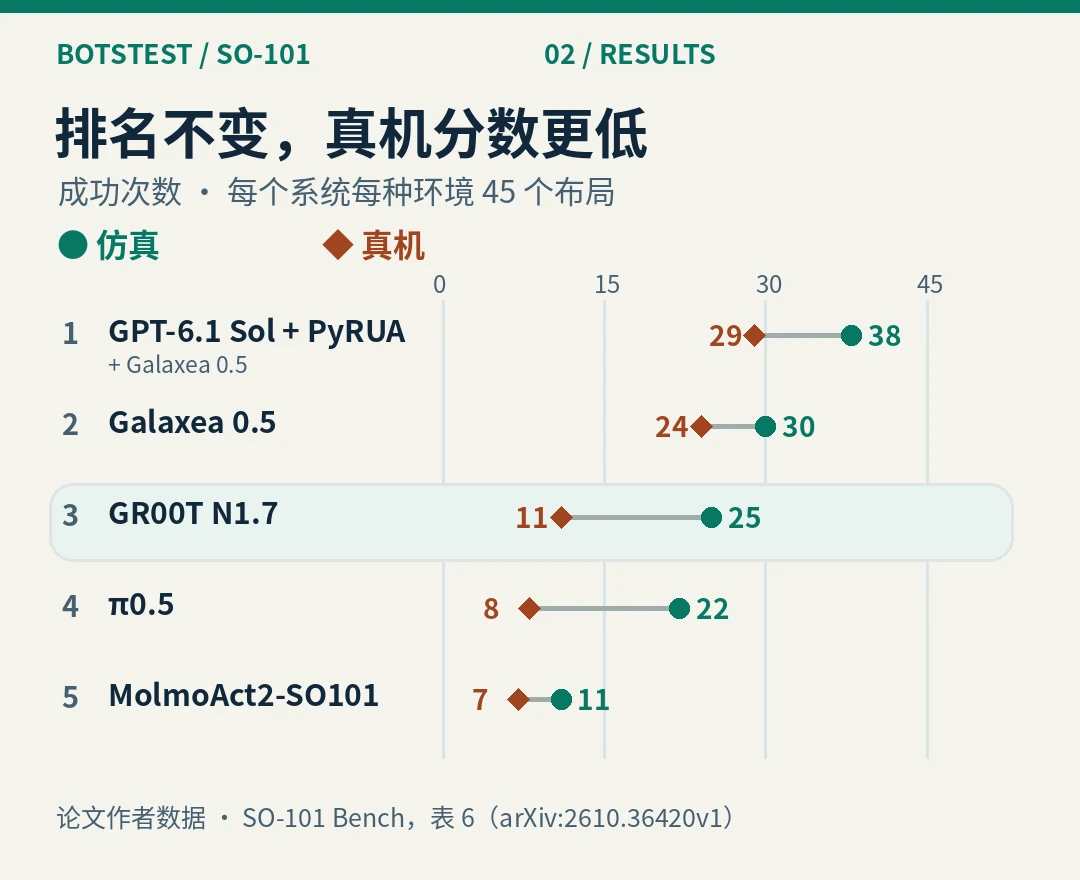
作者表 6;两组使用同一个 0–45 成功次数刻度。
数据来自作者预印本第 5 节、附录 B 表 6,并非 BotsTest 实测。差距按原始次数计算,五套系统都降分,降幅却从 8.9 到 31.1 个百分点不等。用一个统一折扣换算真机得分,解释不了这种差异。
作者固定了什么?
这组测试包括四个学习策略和一个混合系统。每套系统在仿真和真机各跑 45 个配对布局,权重、执行框架、成功规则与时限一致。作者只测了一个真机环境,固定相机和照明;混合系统在同一环境的另一场次运行。
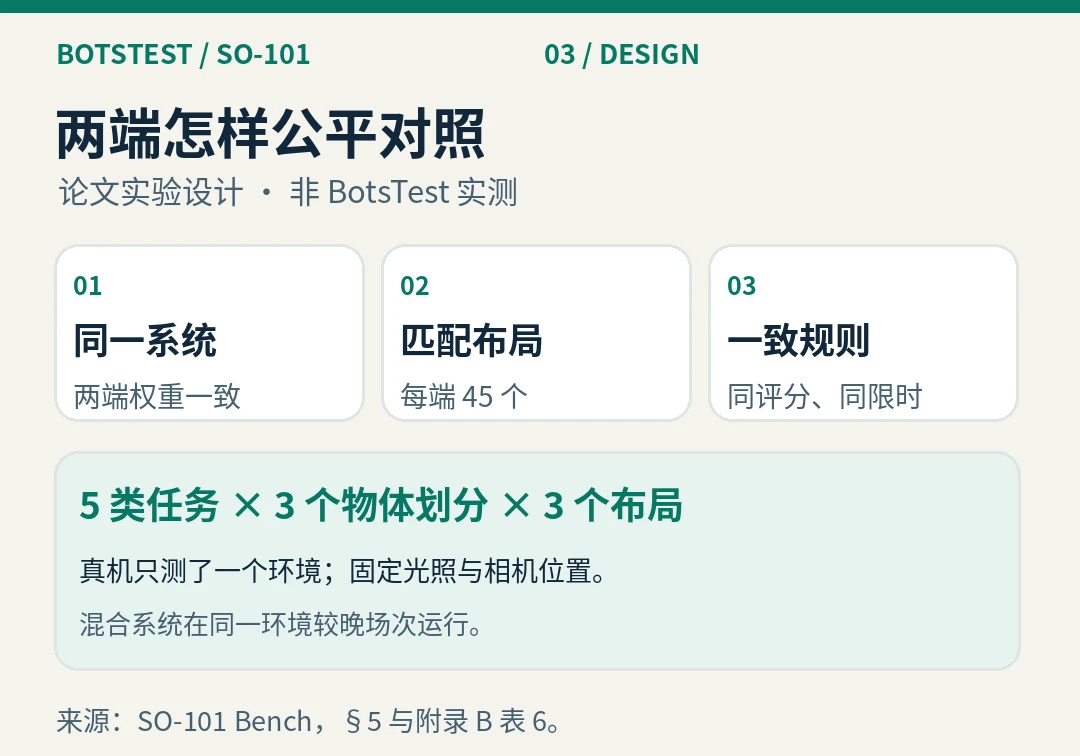
5 类任务 × 3 种物体划分,每个组合 3 个布局。
配对不等于物理属性相同。论文提到真实塑料箱较轻,被推动时容易移位,这是作者观察到的一个可能因素,不是所有差距的解释。逐回合成败一致率也只有 56%–91%;排名相同不等于每次结果相同。
用仿真筛选,用真机验收
- 先定过线标准。 写清什么叫成功、几秒超时、如何计人工干预,再用仿真筛出候选。
- 两边复跑同一批布局。 对齐布局编号、物体和初始位姿,记录权重版本、相机、判分和复位方式。无法对齐的布局单独标记。
- 按次数报告。 分别给出「成功数/尝试数」,单列仿真通过而真机失败的案例。真机没过线,就先查失配,不用仿真名次替代验收。
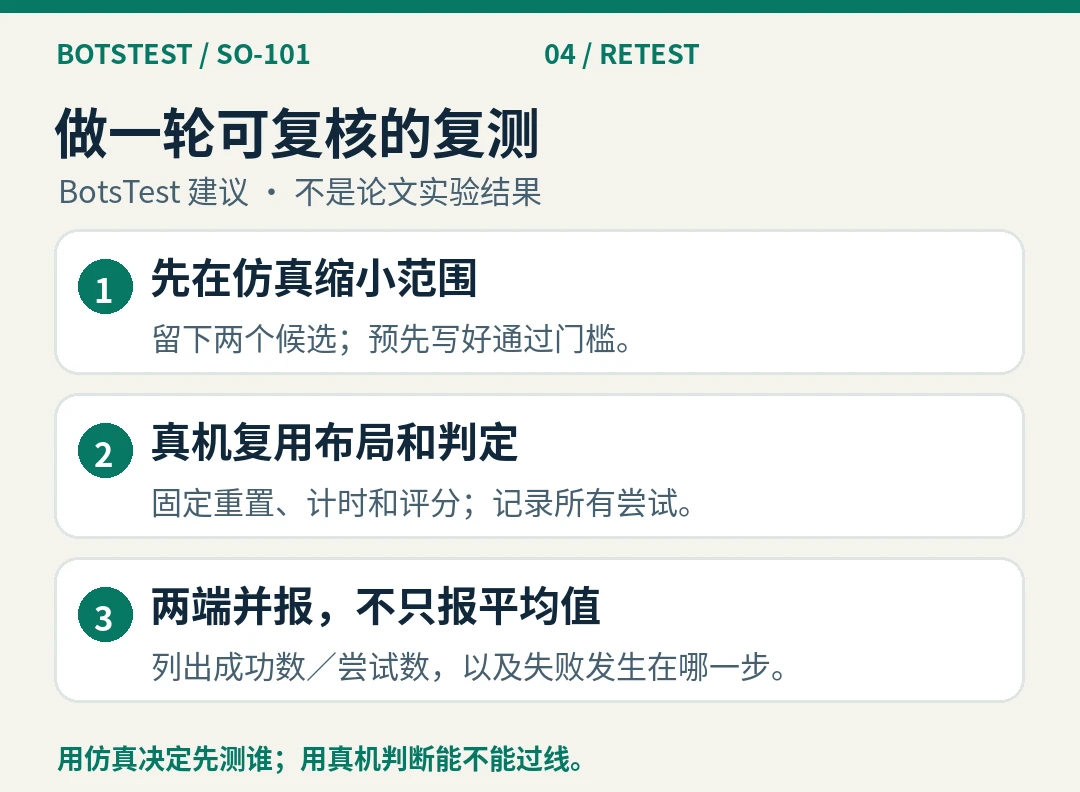
BotsTest 建议的复测流程,不是本次实测。
将入围名单转化为决定
写下任务、操作条件、成功标准和总拥有成本。请入围供应商展示您的代表性任务,包括故障恢复。对每个候选人使用相同的验收测试。
探索完整的机器人目录 →