RoboArena 论文的第 674 组,两种策略都完成了同一项鼠标操作,完成度也相同。评测员却更偏向 B,因为 B 一次就做完了。据评测员描述,A 第一次抓起鼠标后似乎过早掉落,随后重抓并完成。这是论文 v2 附录 D 表 3的一次观察,不是 BotsTest 实测,也不是两款硬件的对比。
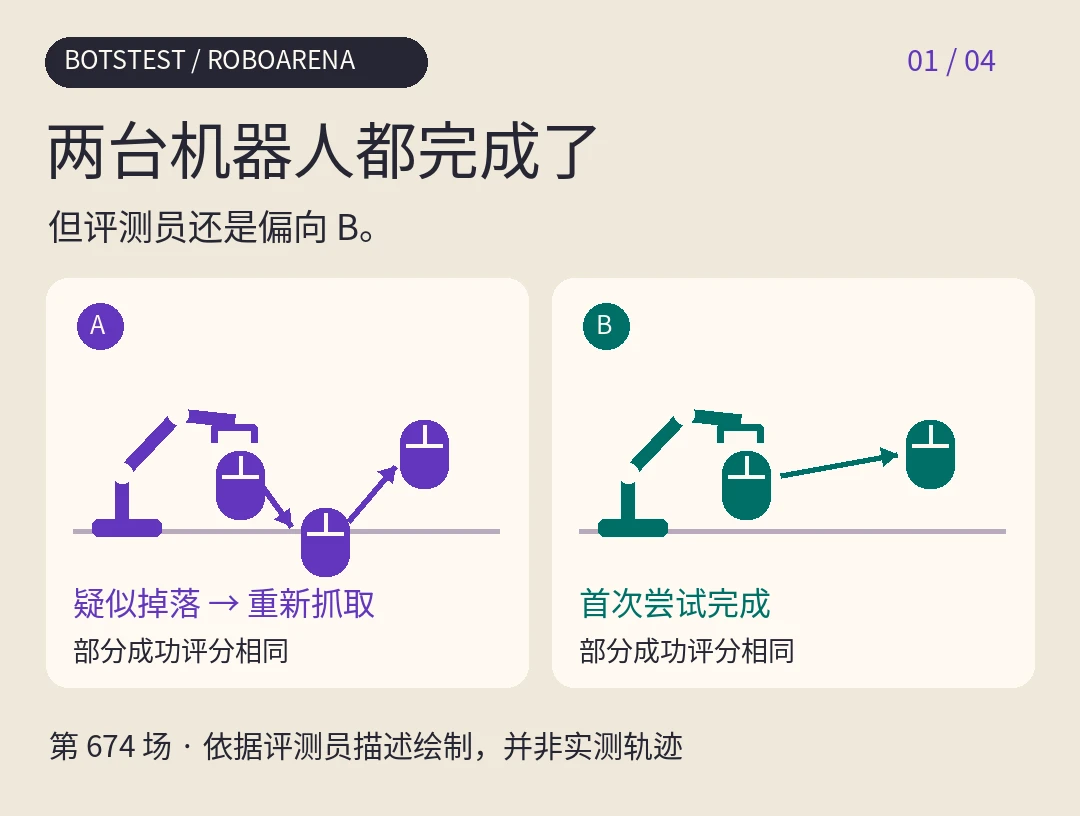
第 674 组,依据评测员记录绘制,不是实拍。
完成度和偏好,回答的是两件事
完成度回答「任务做到哪一步」;偏好回答「你更愿意用哪一次表现,为什么」。本组的理由是一次完成,换个任务可能是误抓、恢复动作或人工干预。偏好能让你找到应该追查的差异,却不是计时结果,也不能拿单次投票排总榜。
成对比较怎么保证公平?
论文第 3.1 节要求同一组 A/B 使用同一任务并尽量匹配初始条件,隐藏策略身份。不同组可以换任务和布置。两次运行分别在完成或达到预设时限时结束。
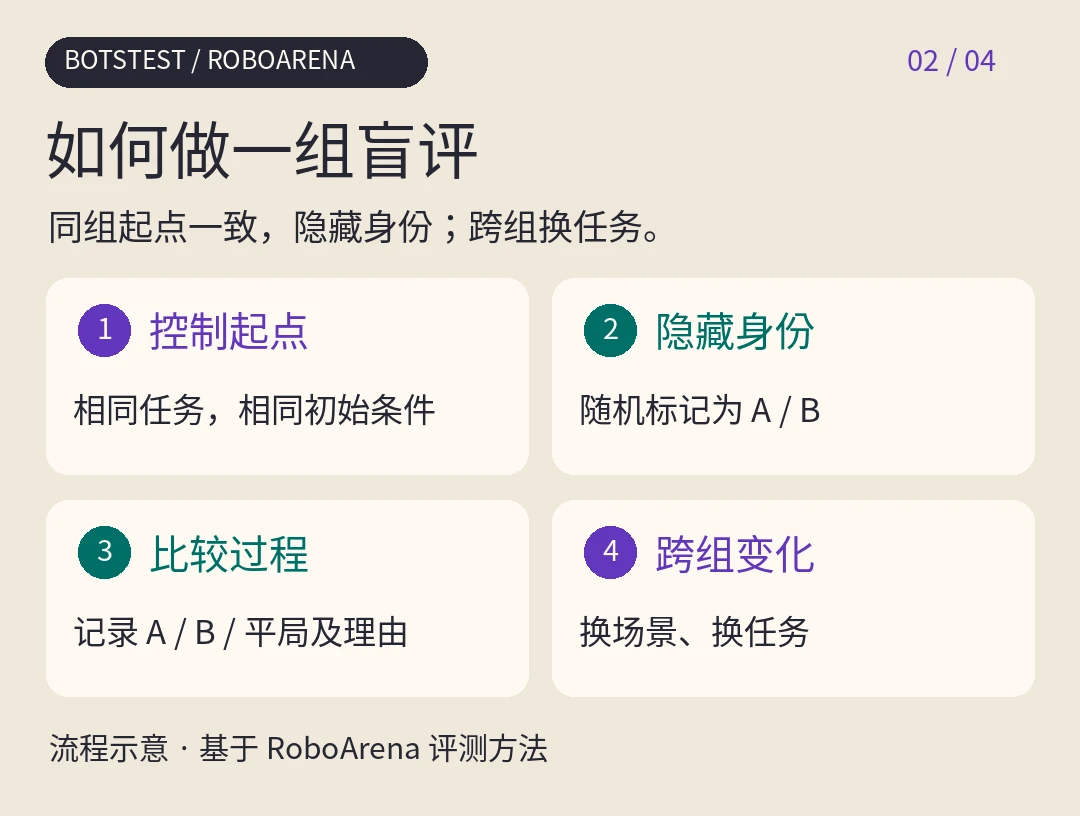
RoboArena 成对评测流程示意。
612 是对比次数,不是运行次数
作者报告了七所大学在 DROID 平台上对七种通用策略进行的 612 次真机成对比较。并不是在同一个鼠标任务上反复跑了 612 次。作者报告,11% 的 A/B 评测中偏好与完成度反馈不一致,既可能是同分但有偏好,也可能是方向相反,不能读成「双成功案例中 11% 有分歧」。
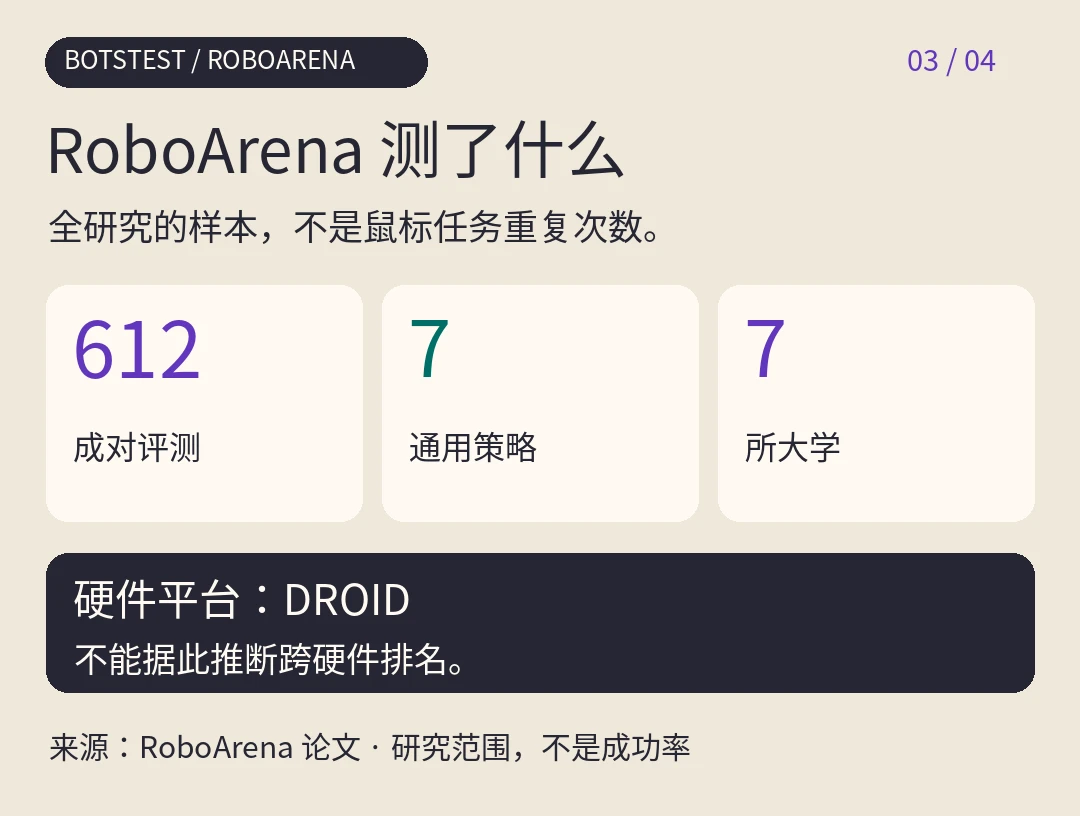
作者报告的研究范围,不代表跨硬件比较。
在自己的工位做一轮 A/B
- 事先写好标准。 分别定义完成、重试、恢复、干预和超时;如果要计时,先确定起止点。
- 组内对齐,组间变化。 同一组重置初始布置、统一任务与限时、隐藏策略身份;后续组再换目标或物体,记录变动。
- 记录分母,保留平局。 每组分别记完成度、次数、干预、偏好或平局和一句理由。汇总时保留有效对数,不把一次偏好外推到另一款硬件。
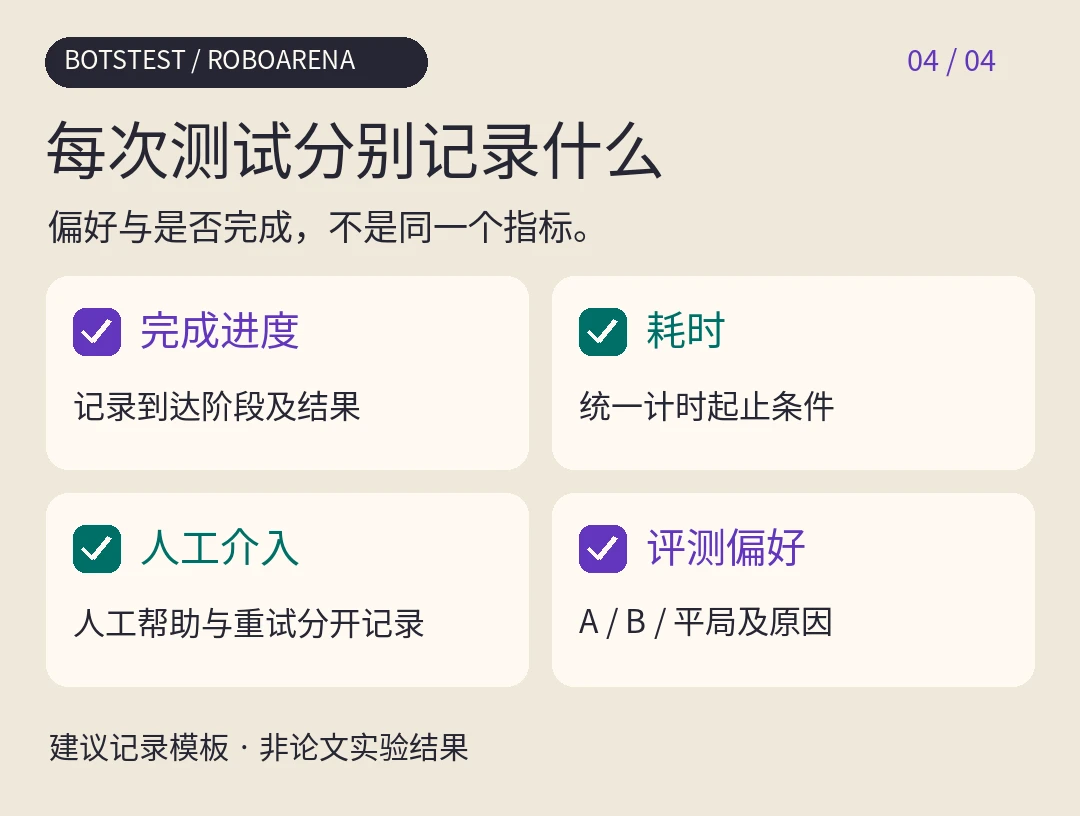
建议记录表,不是原论文数据。
将入围名单转化为决定
写下任务、操作条件、成功标准和总拥有成本。请入围供应商展示您的代表性任务,包括故障恢复。对每个候选人使用相同的验收测试。
探索完整的机器人目录 →