抽屉打开了,任务才刚开始
先开抽屉,把积木推进去,再从抽屉里取出物体、叠积木,最后关上抽屉。这是 CALVIN 论文图 5 里的指令链示例,不是 BotsTest 实测或仿真录像。单独打开抽屉,只证明了一项技能。做完整串指令,还要让每一步留下的状态能接住下一步。
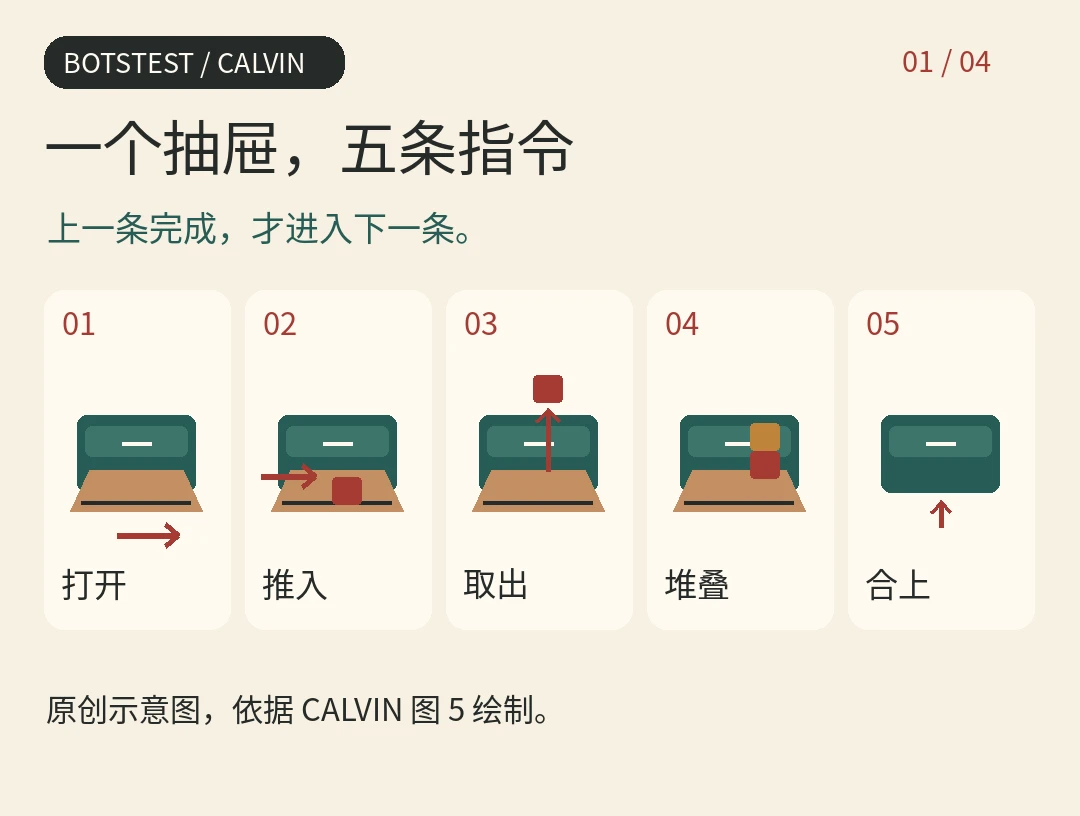
按论文图 5 绘制的五步示意,不是录像。
单项通过率和连做成功率,不能混着看
CALVIN 是一个评估语言指令操控策略的仿真基准。单项测试每次从有效演示的起点初始化;长序列测试则从同一组 34 个任务构造出 1,000 条可行的五步指令链。策略每次只收到当前一条指令;仿真器按状态判定达标后,才会给下一条。子任务之间不把场景复位。它测的是执行与衔接,不是让模型收到一个总目标后自己规划五步。参见论文评测协议和官方实现。
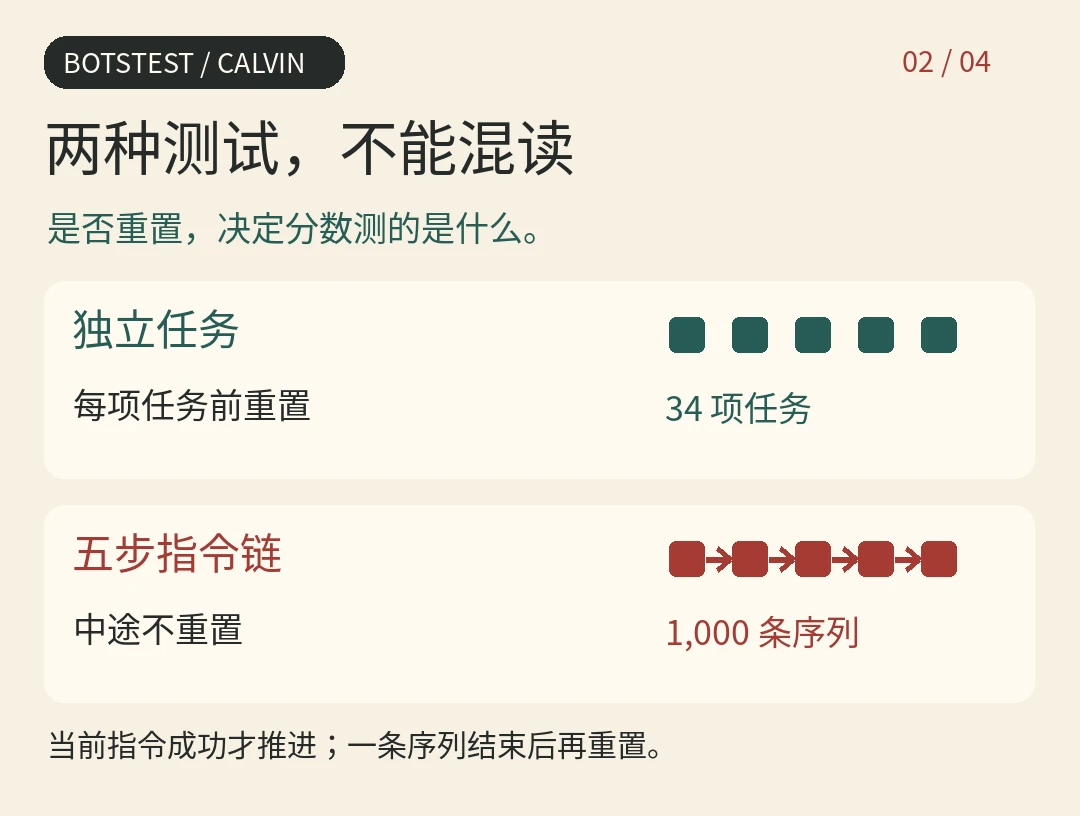
单项重置和连续评估回答不同问题。
掉点最明显的不是最后一步
在论文图 8,作者报告了一组 2022 年仿真基线:多条件模仿学习(MCIL),只用固定 RGB 相机图像,在环境 D 训练,也在 D 测试。单独评估 34 个任务的成功率是 53.9%;连续做成前 1、2、3、4、5 条指令的比例依次是 48.9%、12.9%、2.6%、0.5%、0.08%,沿用论文原值。每个比例的分母都是从头开始的指令链,不是走到当前步骤的样本。这一行最大的掉幅是从做完第一步到连做完前两步;表里没有证据说由某个抽屉动作造成。这是历史仿真基线,不是今天所有模型的上限,也不是真机故障率。
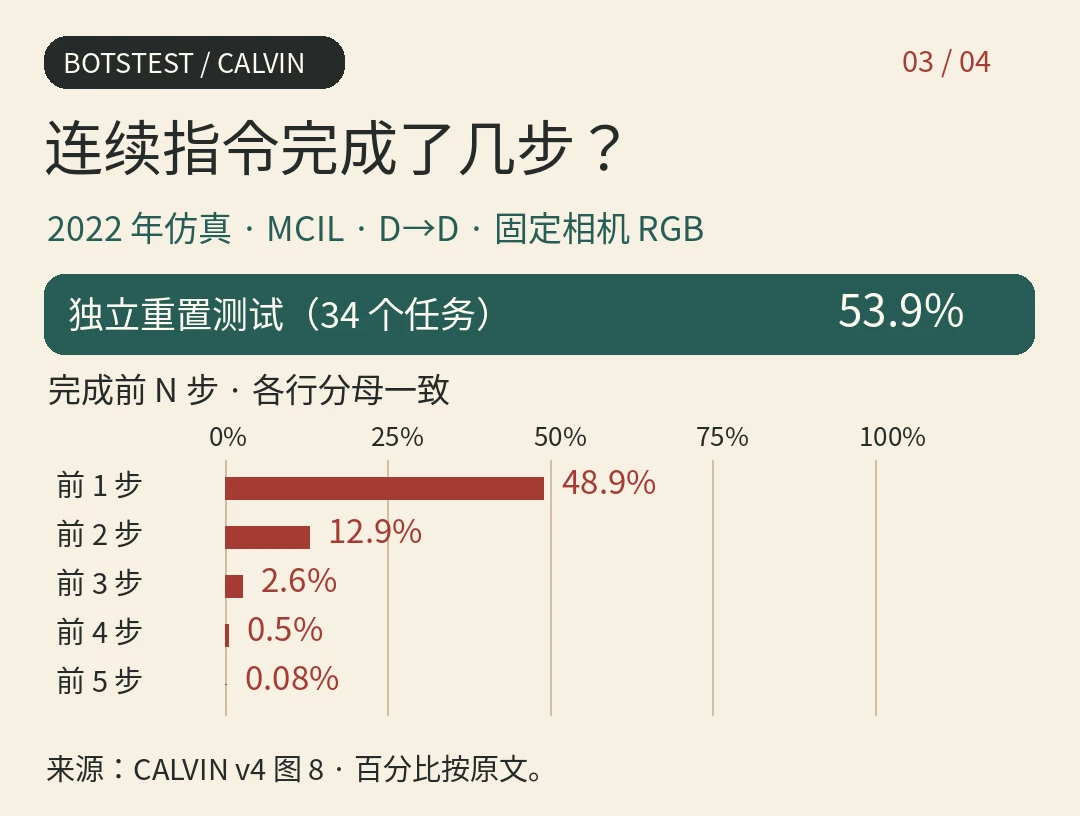
论文图 8 的同一组历史仿真基线,作者测量。
自己测时,把首次失败位置记下来
先固定策略版本、场景划分、指令链、起始状态和超时。逐次记录首次未达标的位置,以及上一步实际留下的状态。把单项成功率和以全部起始样本为分母的「至少连续完成 1、2、3、4、5 步」分别列出。如果掉点在第二步,用同样的判分规则,从一个合法干净初态和第一步实际留下的状态各做一次。这能帮助缩小排查范围,不能单凭它认定失败原因。仿真和真机要分开报告。
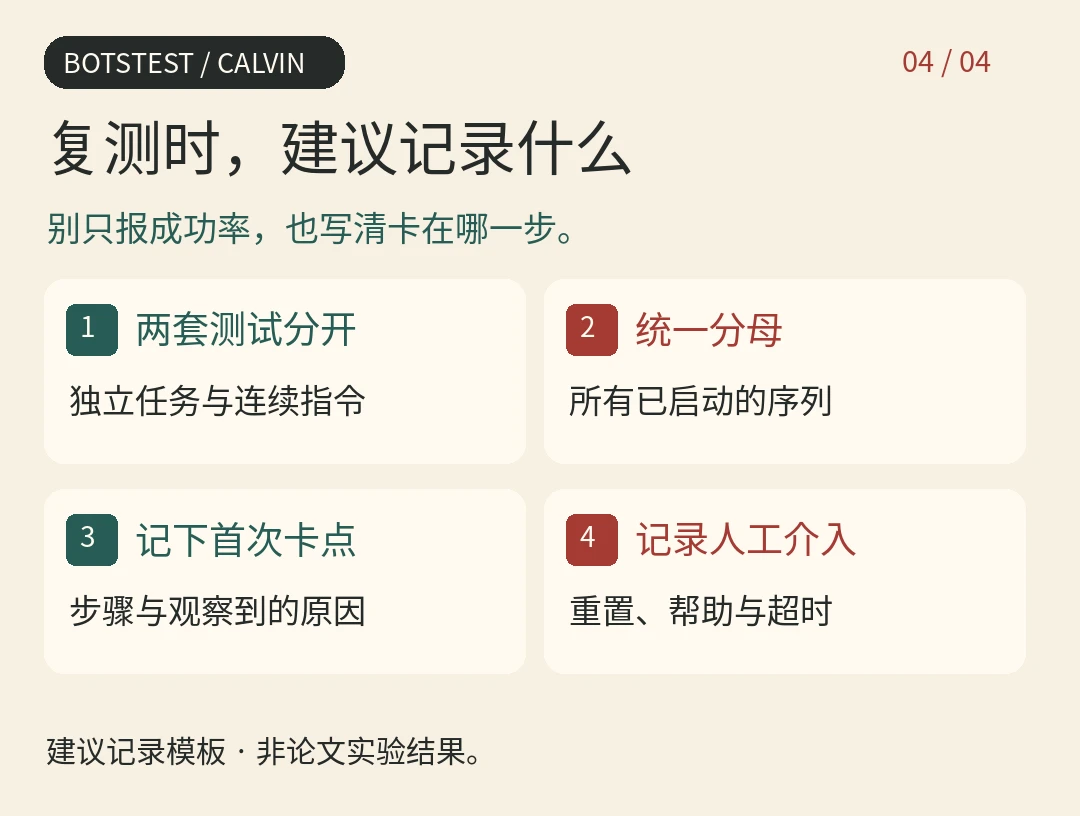
BotsTest 建议的记录项,不是实验新结果。
查看 BotsTest 的 CALVIN 资源页。实验数据出自 Mees 等人的 2022 年 CALVIN 论文 v4;插图为 BotsTest 原创示意,并非仿真实录。
将入围名单转化为决定
写下任务、操作条件、成功标准和总拥有成本。请入围供应商展示您的代表性任务,包括故障恢复。对每个候选人使用相同的验收测试。
探索完整的机器人目录 →